Déclaration. Cette page présente une configuration d'un benchmark construit et exécuté par l'équipe Darkmoon, et cette configuration est notre propre outil open source. Ce n'est pas une évaluation indépendante. Elle complète la comparaison complète des modèles, qui explique le protocole, le barème et pourquoi cette étude ne permet pas de classer les modèles.
Résumé
Lors d'un run (R01, 2026-07-01), la CLI open source Darkmoon pilotant claude-sonnet-4-6 a résolu 16 challenges OWASP Juice Shop pour 43 points de difficulté, soit 10,9 % des 394 points du catalogue, dont le seul challenge à 5 étoiles résolu dans tout le jeu de données (Retrieve Blueprint). Le run a effectué 244 appels LLM réussis et a coûté 17,44 USD, soit 1,09 USD par challenge résolu ; 97,6 % des 36,5 millions de tokens de prompt ont été servis depuis le cache de prompts d'Anthropic. Les 16 résolutions sont toutes intervenues dans les 52,8 premières minutes d'une session de 120,4 minutes.
Deux faits limitent la portée de ce résultat. La cible n'avait pas été réinitialisée : 7 challenges pertinents étaient déjà résolus et ne pouvaient pas être crédités. Et il s'agit d'un seul run d'un couple outil et modèle : il dit comment ce couple s'est comporté une fois, pas si Claude Sonnet 4.6 est « bon en pentest » en général.
Configuration exacte
| Élément | Valeur (telle qu'enregistrée) |
|---|---|
| Configuration / run | C01 / R01 |
| Outil | Darkmoon, CLI open source (github.com/ASCIT31/Dark-Moon) |
| Révision de l'outil | 130f6de (tête de la branche par défaut résolue au Launch ; merge de la pull request #26) |
| Modèle (nom saisi) | claude-sonnet-4-6 |
| Route LLM | proxy LiteLLM -> anthropic/claude-sonnet-4-6 (mesurée) |
| Date (UTC) | 2026-07-01 |
| Statut du run | done (arrêté par l'opérateur) |
| Réglages de l'outil, prompts, matériel | non enregistrés |
La révision est celle que la plateforme a résolue via l'API GitHub au lancement du run [2] ; le champ de référence de l'outil était vide, nous ne pouvons donc pas prouver que la version exécutée localement était exactement ce commit. L'édition open source de Darkmoon correspond à la CLI et à ses agents ; ce run n'implique ni le tableau de bord web Pro ni l'agent de remédiation Pro.
Environnement de test
Cible : une instance OWASP Juice Shop, image Docker bkimminich/juice-shop:latest (empreinte non enregistrée), avec le catalogue de 113 challenges en vigueur en juillet 2026 (394 points). Accès en boîte noire uniquement à travers le proxy de capture de la plateforme, qui journalise chaque requête et renvoie 403 sur /api/challenges*. Les résolutions sont détectées en interrogeant les drapeaux de challenge de Juice Shop environ une fois par seconde, et un challenge rapporte son nombre d'étoiles (1 à 6). Le protocole est publié dans methodology/experimental-protocol.md et l'analyse du barème dans methodology/scoring-methodology.md.
Résultats observés
| Mesure | R01 |
|---|---|
| Challenges résolus (crédités) | 16 |
| Points (somme des étoiles) | 43 (score recalculé, identique au score stocké) |
| Part des points du catalogue | 10,9 % de 394 ; 11,4 % des 377 points encore créditables |
| Durée totale (du Launch au Stop) | 120,4 min |
| Fenêtre de trafic actif | 118,8 min |
| Première / dernière résolution | 3,4 min / 52,8 min après le Launch |
| Requêtes HTTP proxifiées | 7 886 (4 045 chemins distincts) |
| Requêtes par challenge résolu | 492,9 |
| Requêtes bloquées (403 sur /api/challenges*) | 121 |
| Points par heure (durée totale) | 21,4 |
Les 121 requêtes bloquées ne prouvent pas une tentative de lire les solutions : la plupart sont la forme avec barre oblique finale de l'endpoint, et le front-end de Juice Shop peut lui-même émettre ces appels quand un navigateur est piloté à travers le proxy. Nous ne l'avons pas vérifié dans le code du front-end : nous donnons le nombre sans l'interpréter.
Aucun extrait de trace
Les challenges résolus
| Minute | Challenge | Catégorie | Étoiles |
|---|---|---|---|
| 3,4 | Outdated Allowlist | Unvalidated Redirects | 1 |
| 4,3 | Database Schema | Injection | 3 |
| 6,8 | Login Jim | Injection | 3 |
| 7,4 | View Basket | Broken Access Control | 2 |
| 8,8 | Zero Stars | Improper Input Validation | 1 |
| 9,0 | Reset Jim's Password | Broken Authentication | 3 |
| 10,9 | Forged Review | Broken Access Control | 3 |
| 12,8 | Access Log | Observability Failures | 4 |
| 14,2 | Admin Registration | Improper Input Validation | 3 |
| 15,1 | Retrieve Blueprint | Sensitive Data Exposure | 5 |
| 19,1 | Forged Feedback | Broken Access Control | 3 |
| 20,4 | Deprecated Interface | Security Misconfiguration | 2 |
| 20,4 | XXE Data Access | XXE | 3 |
| 41,8 | Security Policy | Miscellaneous | 2 |
| 42,9 | Login Bender | Injection | 3 |
| 52,8 | Admin Section | Broken Access Control | 2 |
Par difficulté : 2 challenges à une étoile, 4 à deux, 8 à trois, 1 à quatre et 1 à cinq, aucun à six. Par catégorie, Broken Access Control (4) et Injection (3) arrivent en tête, puis Improper Input Validation (2), avec une résolution dans chacune de sept autres catégories. Deux résolutions n'apparaissent dans aucun autre run valide du jeu de données : Reset Jim's Password et Retrieve Blueprint.
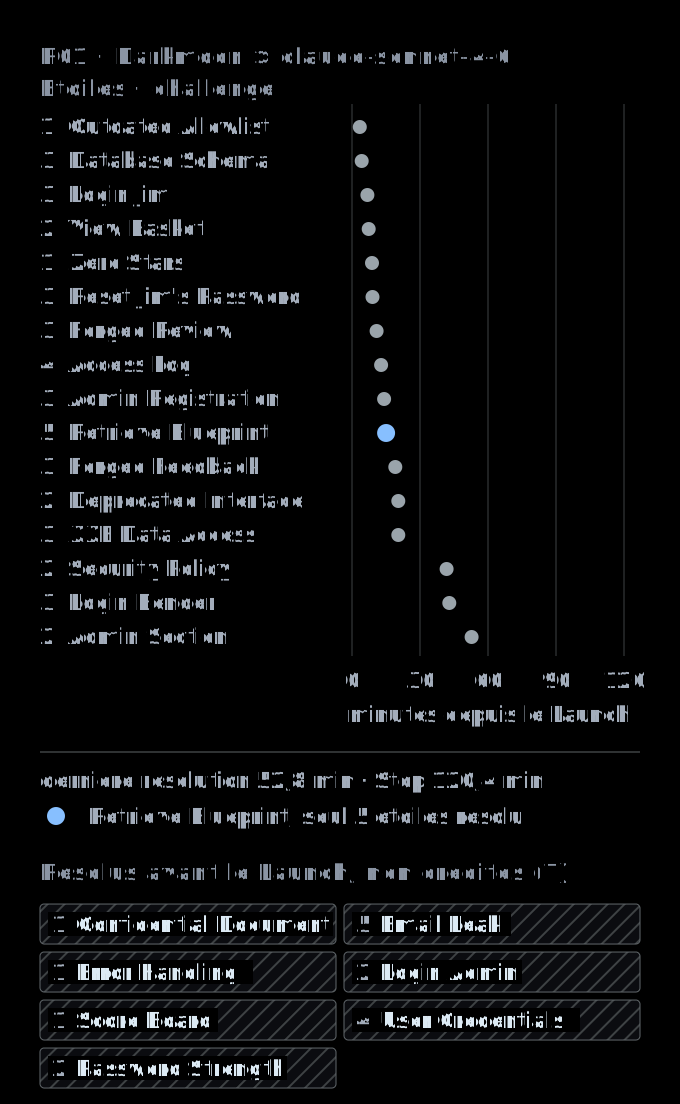
La cible non réinitialisée
Quand l'opérateur a cliqué Launch, Juice Shop indiquait déjà comme résolus : Confidential Document (1 étoile), Error Handling (1), Score Board (1), Login Admin (2), Password Strength (2), User Credentials (4) et Email Leak (5), plus le drapeau ambiant Exposed Metrics présent au début de chaque run. La plateforme a correctement refusé de les créditer. Ensemble, ils pèsent 16 points.
Plusieurs d'entre eux comptent parmi les challenges les plus souvent résolus de l'étude (Error Handling résolu dans 14 des 15 runs valides où il était créditable, Login Admin dans 12 sur 15) : une cible neuve aurait probablement offert à R01 quelques points faciles. Nous ne les ajoutons pas : savoir si R01 les aurait résolus, et quand, est inconnu, et ajuster le score reviendrait à inventer un résultat.
Coût, tokens et temps
| Mesure | Valeur |
|---|---|
| Appels LLM réussis | 244 |
| Tokens de prompt | 36 519 632 |
| dont lectures de cache | 35 635 401 (97,6 %) |
| dont écritures de cache | 883 983 (2,4 %) |
| dont entrée hors cache | 248 |
| Tokens de complétion | 229 194 |
| Tokens moyens de prompt / complétion par appel | 149 671 / 939 |
| Coût (tarif LiteLLM) | 17,44 USD |
| Coût par challenge résolu / par point | 1,09 USD / 0,41 USD |
| Coût par heure de durée totale | 8,70 USD |
Ces chiffres sont sommés à partir du journal de dépense de LiteLLM sur la fenêtre exacte du run [3]. Les valeurs stockées par la plateforme sont légèrement plus basses (17,37 USD, 36 443 691 tokens de prompt et 225 920 de complétion), car elle n'écrit ses métriques qu'à chaque interrogation en direct : les derniers appels avant le Stop ont été manqués ; l'écart est de 0,42 %. L'attribution suppose qu'aucun autre usage LLM n'a eu lieu dans cette fenêtre, ce qui est plausible (un seul run actif à la fois) mais pas démontrable. Le coût correspond aux tarifs publics connus de LiteLLM, pas à une facture.
Le profil est celui d'un agent à long contexte : en moyenne, chaque appel renvoyait environ 150 000 tokens de contexte et en produisait moins de mille. C'est le cache de prompts qui rend une telle boucle abordable. Le profil temporel compte autant : 13 des 16 résolutions sont arrivées dans les 20,4 premières minutes, et la session a encore duré 67,6 minutes après sa dernière résolution. Un coût par challenge résolu calculé sur toute la session dépend donc du moment où l'opérateur a cliqué Stop.
Comparaison avec les autres configurations
R01 est le meilleur run unique du jeu de données, mais de justesse. R17 (C12, kimi-k3, outil non enregistré) a lui aussi résolu 16 challenges, pour 42 points, dans une fenêtre active de 80,0 minutes et sur une cible neuve ; R19 (C14, gemini-3.1-pro-preview, outil non enregistré) a atteint 31 points en 29,0 minutes. Un point d'écart entre deux runs uniques, avec des budgets de temps et des états de cible différents, n'est pas un classement, et nous ne le lisons pas comme tel.
Les deux meilleurs runs partagent 8 challenges résolus. R01 seul a résolu Outdated Allowlist, Login Jim, Reset Jim's Password, Retrieve Blueprint, Deprecated Interface, XXE Data Access, Security Policy et Login Bender ; R17 seul a résolu Christmas Special, Deluxe Fraud, Payback Time et Upload Type, plus quatre challenges que R01 ne pouvait pas gagner car déjà résolus (Confidential Document, Error Handling, Login Admin, User Credentials).
Surtout, un résultat décrit le couple. Le même claude-sonnet-4-6 dans un autre agent, ou Darkmoon avec un autre modèle, pourrait obtenir un autre score ; et comme les outils de C02 à C16 ne sont pas enregistrés, le jeu de données ne permet pas de séparer la contribution du modèle de celle de Darkmoon. Le coût ne peut pas du tout être comparé, C01 étant la seule configuration mesurée. Pour un recoupement du comportement de Darkmoon sur Juice Shop hors de cette plateforme, voir les résultats de Darkmoon sur Juice Shop en six campagnes, et pour notre façon de noter, pourquoi nous notons sur preuve (en anglais).
Limites de ce résultat
- Run unique. Aucune estimation de variance n'est possible pour C01 ; les configurations à deux runs de l'étude montrent un faible recouvrement entre runs (Jaccard de 0 à 0,6).
- Arrêt par l'opérateur. Le run s'est terminé quand l'opérateur a cliqué Stop, pas sur un budget fixe.
- Cible non réinitialisée. Sept challenges pertinents (16 points) ne pouvaient pas être crédités.
- Sélection. Des configurations Darkmoon antérieures (« Darkmoon Community » et « Darkmoon » avec claude-sonnet-4-6) ont été supprimées de la plateforme avant les sauvegardes et leurs runs ne sont pas récupérables ; R01 est celui qui subsiste et n'est peut-être pas représentatif.
- Construit mesuré. Les points sont la difficulté attribuée par les auteurs de Juice Shop ; il n'y a aucun axe faux positifs, qualité du rapport ou preuve d'exploitation, et la cible est une application d'entraînement.
- Réglages non enregistrés. La configuration de Darkmoon, les prompts et le matériel n'ont pas été conservés ; l'empreinte de Juice Shop est inconnue.
- Non indépendant. Construit et exécuté par l'équipe Darkmoon.
Reproduire et vérifier
Le dossier de résultats exact de cette configuration est results/configs/C01.md dans l'étude Darkmoon-Benchmarks llm-pentest-juice-shop-2026 (périmètre : benchmarks de pentest LLM sur OWASP Juice Shop). La ligne du run est dans datasets/results.csv, la comparaison avec toutes les autres configurations dans results/global-comparison.md, et ce qui peut ou non être reproduit est listé dans reproducibility/README.md. Pour lancer le même outil contre votre propre lab, partez du dépôt open source : github.com/ASCIT31/Dark-Moon (commit 130f6de). Pour l'utiliser avec un modèle local plutôt qu'une API cloud, voir Darkmoon entièrement en local (en anglais).
Références
- Équipe Darkmoon. Quel LLM choisir pour le pentest ? Un benchmark reproductible sur OWASP Juice Shop (l'étude globale). dark-moon.org/fr/blog/llm-pentesting-benchmark/
- ASCIT31/Dark-Moon, commit 130f6de (merge de la pull request #26). github.com/ASCIT31/Dark-Moon/commit/130f6de672de1cde3bbc0d3fb34988bcd3a64617
- Documentation LiteLLM. Spend tracking (LiteLLM_SpendLogs). docs.litellm.ai/docs/proxy/cost_tracking
- OWASP Foundation. Page du projet OWASP Juice Shop. owasp.org/www-project-juice-shop/
- Kimminich, B. Pwning OWASP Juice Shop, guide compagnon : Challenges (échelle de difficulté). pwning.owasp-juice.shop/companion-guide/latest/part1/challenges.html
- Équipe Darkmoon. Page de résultats de la configuration C01 dans Darkmoon-Benchmarks. github.com/ASCIT31/Darkmoon-Benchmarks/blob/main/studies/llm-pentest-juice-shop-2026/results/configs/C01.md
La preuve plutôt que le discours : le benchmark de remédiation Pro (correctifs retestés contre l'exploit) · Darkmoon face aux autres outils de pentest IA.
← Tous les articles