Le pentest autonome change la forme de ce qu’on lit à la fin. Un testeur humain rédige un rapport d’une douzaine de constats ; un système multi-agents peut en rendre plusieurs dizaines par cible, chacun qualifié et rattaché à un actif, une technique et une preuve. Le goulot d’étranglement passe de la découverte à la compréhension. Les vues spatiales et immersives, du graphe 3D sur écran à la session WebXR dans un casque depuis le navigateur, sont souvent présentées comme la réponse. Cet article cherche ce que la recherche soutient réellement, ce qu’elle ne soutient pas, et où se situe notre propre implémentation face à ces résultats.
Il complète, sur le plan scientifique, le récit de la refonte de notre graphe d’infrastructure (en anglais), qui raconte l’histoire produit. Nous ne la répétons pas ici. Nous passons en revue la littérature sur les graphes d’attaque, la visualisation de graphes et l’analytique immersive, nous décrivons les standards web concernés, nous auditons le code que nous livrons, et nous terminons par des hypothèses et un protocole expérimental que nous n’avons pas encore mené.
La question, et comment lire cette étude
Dans quelle mesure une vue immersive pourrait-elle améliorer six choses : la compréhension de la surface d’attaque, la navigation dans de grands graphes, l’identification des chemins d’exploitation, la priorisation des vulnérabilités, la communication entre pentesters, analystes SOC et décideurs, et la compréhension de ce qu’a fait un système autonome ? Nous employons trois étiquettes du début à la fin, sans les mélanger.
- Démontré. Rapporté par une étude évaluée par les pairs ou par un standard que nous avons lu, avec les conditions dans lesquelles le résultat tient.
- Implémenté. Présent dans le code de Darkmoon, avec le dépôt (et le commit quand le dépôt est public). Implémenté ne veut pas dire évalué.
- Hypothèse. Plausible, mais non testé par nous ni, à notre connaissance, par quiconque dans ce cadre précis.
Réponse courte
Graphe d’attaque et arbre d’attaque : définitions
Les modèles graphiques de sécurité sont, selon une revue récente, une manière connue et accessible de représenter la sécurité d’un système [17]. Deux familles dominent. Un arbre d’attaque décompose un objectif de l’attaquant en sous-objectifs reliés par des raffinements ET/OU : il est centré sur le but et hiérarchique. Un graphe d’attaque représente comment un attaquant passe d’un état ou d’un privilège à l’autre dans un système concret : les nœuds sont des conditions ou des exploits, les arêtes les relations qui les rendent possibles, et un chemin est une compromission en plusieurs étapes. Sheyner et al. notaient en 2002 que les graphes d’attaque étaient alors construits à la main par les red teams, un travail qu’ils jugent fastidieux et sujet aux erreurs, et les ont générés automatiquement par model checking symbolique [13]. MulVAL a ensuite encodé vulnérabilités, configurations et règles de privilèges en Datalog, avec une analyse en quelques secondes sur des réseaux de milliers de machines [14]. La construction manuelle ne passe pas à l’échelle et la génération automatique reste un champ actif [17].
La syntaxe visuelle n’est pas fixée. Lallie, Debattista et Bal ont analysé plus de 180 graphes et arbres d’attaque et n’ont trouvé aucune syntaxe visuelle standard : plus de soixante-dix configurations de graphes et une vingtaine d’arbres, chacune dessinant préconditions et exploits à sa façon, avec très peu d’évaluation empirique ou comparative de ces choix [16]. Toute équipe qui dessine un chemin d’attaque, la nôtre comprise, prend donc des décisions de conception que le domaine n’a pas validées.
| Arbre d’attaque | Graphe d’attaque (modèle) | Graphe de preuves (Darkmoon) | |
|---|---|---|---|
| Unité | But et sous-buts | Condition ou exploit | Actif portant des constats qualifiés |
| Une arête signifie | Raffinement (ET/OU) | Permet / précondition | Contient / s’exécute sur (structure découverte) |
| Construit à partir de | Savoir de l’analyste | Configuration + données de vulnérabilités | Ce que les agents ont observé et prouvé |
| Peut contenir du non prouvé | Oui | Oui, par construction (ce qui pourrait arriver) | Oui, mais marqué non confirmé |
| Risque principal | Buts incomplets | Explosion combinatoire, lecture difficile | Aussi complet que le test, pas plus |
D’où viennent les arêtes : modèles d’atteignabilité ou preuves
Un graphe d’attaque classique répond à la question « que pourrait faire un attaquant avec cette configuration ». Il raisonne sur des préconditions : un chemin peut exister sans avoir jamais été exécuté. C’est sa force (la couverture) et sa faiblesse pour un décideur (un chemin est une hypothèse sur le réseau). Un pentest autonome produit l’objet inverse : un ensemble de constats réellement tentés contre la cible. Dans le moteur open source de Darkmoon, le playbook des agents impose d’attribuer à chaque constat un statut fondé sur l’impact démontré, pas sur l’observation : EXPLOITED (impact exécuté de bout en bout), CONFIRMED (requête exacte, réponse brute et données extraites ou trace d’exécution) ou UNCONFIRMED (piste réelle dont l’impact n’est pas démontré, maintenue en sévérité faible avec un CVSS d’au plus 3,9). La règle figure dans le playbook des agents conf/agents/pentest.md de ASCIT31/Dark-Moon (commit 1b6af79). Nous expliquons ailleurs pourquoi nous préférons la preuve d’exploitation à un score et comment les agents produisent les constats affichés par le graphe (articles en anglais).
Les deux objets ont besoin de MITRE ATT&CK comme langue commune, et ATT&CK impose une prudence que les visualisations oublient souvent. La matrice définit une tactique comme le but tactique de l’adversaire, « la raison pour laquelle il effectue une action » ; au moment de la rédaction, la matrice Enterprise (v20) compte quinze tactiques, de Reconnaissance à Impact, dont les tactiques renommées Stealth et Defense Impairment [11]. Une technique n’est pas liée à une seule tactique : Valid Accounts (T1078) relève à la fois de Stealth, Persistence, Privilege Escalation et Initial Access [12]. Aligner les techniques sur une seule kill chain de gauche à droite est donc un choix de modélisation, utile pour raconter, mais pas une propriété des données.
Visualiser un graphe d’attaque en 2D
Le problème de lisibilité est ancien. Noel et Jajodia relevaient en 2005 que les dessins de graphes de l’époque rendaient ces graphes « souvent grands et complexes » difficiles à comprendre, et proposaient des matrices d’adjacence regroupées [15]. Leur intuition rejoint une étude contrôlée sur des graphes génériques : Ghoniem, Fekete et Castagliola ont montré qu’au-delà d’une vingtaine de sommets, la matrice bat le diagramme nœuds-liens sur la plupart de sept tâches génériques, avec une exception constante, la recherche de chemin, toujours favorable au nœuds-liens [18]. Cette exception compte ici : suivre un chemin d’attaque est une tâche de recherche de chemin.
La recherche classique sur la perception graphique ajoute une contrainte. Cleveland et McGill ont ordonné les tâches perceptives élémentaires selon la précision avec laquelle on les accomplit, et recommandé d’encoder les grandeurs avec les tâches les mieux placées dans cet ordre [19]. Une disposition où le rayon encode l’exposition, comme dans notre graphe orbital, confie une variable ordinale à la position ; la perspective et la rotation en 3D déforment les distances à l’écran, une raison de garder une vue de face par défaut.
Analytique immersive : ce qu’apportent la 3D et la VR, et ce qu’elles coûtent
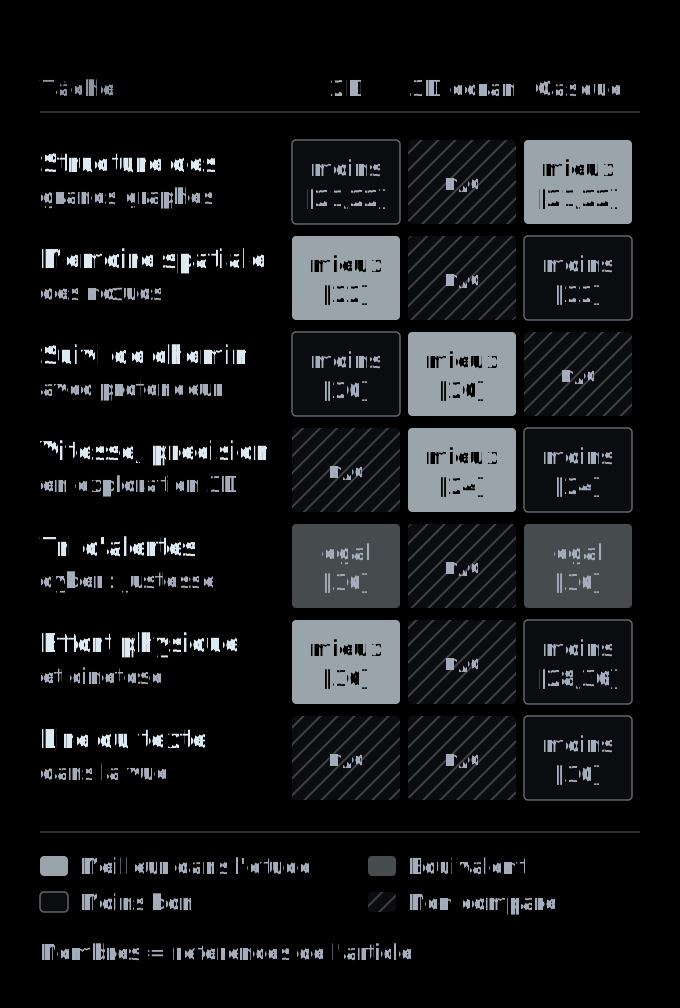
L’analytique immersive, l’usage de la VR, de l’AR et des grands écrans pour analyser des données, est devenue un champ structuré : 24 experts lui ont fixé 17 grands défis à CHI 2021 [26], et une revue de 2025 sur l’analyse visuelle de réseaux en environnement immersif couvre 138 publications, 87 applications et 59 évaluations utilisateurs [25]. Les résultats utiles pour les graphes d’attaque suivent ; la figure 1 les résume par tâche.
Résultats favorables
- Les indices de profondeur aident à suivre un chemin. Ware et Franck ont montré que la stéréo couplée aux mouvements de la tête multipliait environ par trois la taille d’un graphe compréhensible, la stéréo seule par 1,6 et le couplage à la tête par 2,2 ; le mouvement structuré aidait davantage que la stéréo [20].
- L’immersion peut aider sur de plus grands graphes. Kwon et al. rapportent des réponses nettement plus rapides et avec moins d’interactions grâce à leurs techniques immersives, surtout pour les tâches difficiles ; la justesse globale ne diffère pas, mais les réponses sont plus souvent correctes sur les grands graphes [21]. Kotlarek et al. constatent une interprétation de la structure plus juste en immersion, en particulier pour les réseaux plus grands [22].
- Le casque est viable pour l’analyse à plusieurs. Dans une tâche collaborative de connectivité, les binômes en casque étaient plus rapides qu’en CAVE2, sans différence de justesse ni de communication [23].
Résultats défavorables ou mitigés
- La 2D gagne sur la mémoire spatiale. La même étude de Kotlarek trouve la 2D meilleure pour les tâches de mémoire spatiale [22], celle qui sert à revenir sur « cet actif-là ».
- Le poste de bureau est souvent le plus rapide et le plus précis. En comparant un HoloLens, une tablette et un poste de bureau pour explorer de la 3D avec 15 participants, Bach et al. trouvent chaque environnement meilleur pour certaines tâches, mais le bureau le plus rapide et le plus précis dans presque tous les cas [24].
- Tout dépend de la tâche, et les graphes testés sont petits. La revue de 2025 signale des résultats mitigés ou négatifs dans plusieurs études, des réseaux de 5 à 7 885 nœuds avec une médiane de 120, très peu d’études sur la complexité des données et une seule sur le passage à l’échelle [25].
- La présence n’est pas l’apprentissage. Dans une étude 2×2 auprès de 52 étudiants, ajouter la VR immersive à une simulation scientifique augmente la présence (d = 1,30) mais réduit l’apprentissage (d = 0,80) et augmente la charge cognitive mesurée par EEG (d = 0,59) [31]. Le domaine n’est pas la sécurité, mais l’avertissement sur la nouveauté et la surcharge se transpose.
Coûts humains : cinétose, confort, texte
Une méta-analyse de 55 études (3 016 participants) montre que le contenu influe nettement sur la cinétose en VR ; parmi les modes de déplacement, le déplacement à la manette donne les scores totaux les plus élevés et la marche réelle les plus bas [28]. Une revue des causes note qu’une meilleure qualité visuelle ne réduit pas à elle seule la cinétose de façon fiable [29]. Le texte est un problème de fond : Novotny et Laidlaw ont mesuré la vitesse de lecture sur deux casques et un CAVE, et même les affichages VR haute fidélité ont une taille critique de lecture supérieure à celle d’un texte physique comparable [30]. Une visualisation de sécurité, ce sont surtout des étiquettes, des identifiants et des preuves : ce coût est central, pas marginal.
Visualisation immersive en cyberdéfense et en SOC
La conscience de situation fournit le vocabulaire. Le modèle d’Endsley distingue perception, compréhension et projection, et désigne l’attention et la mémoire de travail comme les limites critiques pour acquérir et interpréter l’information [32]. La revue systématique de Franke et Brynielsson sur la conscience de situation cyber couvre 102 articles et la définit comme le sous-ensemble cyber de la conscience de situation générale [33].
Les travaux immersifs dans ce domaine existent mais sont jeunes. Kabil et al. ont conçu un environnement 3D collaboratif d’analyse cyber après avoir visité des SOC français [34] ; dans une étude d’utilisabilité ultérieure, 30 participants sans connaissance en cybersécurité ont mené une analyse d’alertes simplifiée inspirée de WannaCry, avec des scores SUS supérieurs à 70 dans les trois variantes et une préférence pour l’environnement couplé graphe plus bureau [35]. Cette étude compare des variantes immersives entre elles, pas avec un outil 2D. Delcombel, Duval et Pahl ont, eux, comparé VR et 2D pour le tri d’alertes sur des données OT périodiques avec 24 volontaires : taux de classification équivalent, temps de réponse sans différence significative sur la première série d’alertes et plus court en VR sur la seconde, SUS comparable (77 contre 74), version VR jugée plus exigeante physiquement et génératrice d’un flow plus élevé, et les trois experts interrogés ont noté que la VR les coupe de leurs outils habituels [36]. Kullman et Engel soutiennent que, pour aider un expert en cybersécurité, l’interaction doit être exempte de tâches mentales supplémentaires et la disposition doit correspondre à sa propre représentation [37].
Une revue de 2024 sur les systèmes immersifs de conscience de situation cyber retient 43 études, la plupart évaluées par des études utilisateurs à faible effectif (6 à 208 participants dans le tableau publié), et relève un manque net de techniques pour le niveau projection [38]. Or la projection, anticiper le prochain mouvement de l’attaquant, est précisément ce qu’une vue de chemin d’attaque prétend soutenir.
Visualiser ce qu’a fait un agent IA
Deux autres pistes concernent les systèmes autonomes. Les auteurs de PentestGPT montrent que les LLM traitent bien les sous-tâches d’un test d’intrusion mais peinent à garder une compréhension intégrée du scénario complet [39] : la même fragmentation atteint l’humain qui lit le résultat. AgentLens construit une visualisation hiérarchique, causale et temporelle à partir des journaux d’exécution bruts des agents [40] : expliquer un agent, c’est aussi une question de provenance et de temps, pas seulement de topologie. Enfin, les facteurs humains de l’automatisation mettent en garde contre le mésusage (confiance excessive) et le non-usage (abandon après de fausses alertes), la saillance des indicateurs d’état de l’automatisation faisant partie des facteurs [41]. Pour la sortie d’un pentest autonome, l’indicateur d’état honnête est le statut de preuve de chaque constat : une vue qui le masque invite à la surconfiance.
La WebXR Device API comme canal de diffusion
WebXR est l’API du W3C qui permet à une page web d’afficher sur des appareils VR et AR. Au moment de notre lecture, la spécification principale est un Candidate Recommendation Draft daté du 9 juin 2026 [1]. Plusieurs de ses règles conditionnent tout outil de sécurité bâti dessus :
- Contexte sécurisé uniquement.
navigator.xretXRSessionsont réservés aux contextes sécurisés [1] : un tableau de bord auto-hébergé doit être servi en HTTPS (ou en localhost) pour proposer la VR. - Détection sans invite.
isSessionSupported()ne doit pas déclencher d’interface de choix d’appareil [1], ce qui permet de sonder la VR en silence et de garder la vue 2D par défaut. - Modes et permissions.
inline,immersive-vretimmersive-ar(défini par le module AR) ; les modes immersifs exigent la politique de permissionsxr-spatial-tracking, et les espaces de référence au niveau du sol demandent toujours le consentement de l’utilisateur [1]. - Budget de trame. À l’état visible, les callbacks de
XRSession.requestAnimationFrames’exécutent à la fréquence native de l’appareil [1] : la scène doit être dessinée pour chaque vue (en général une par œil) dans ce budget. - Entrées. L’interaction arrive sous forme d’événements
selectetsqueezesur des sources d’entrée [1]. Sur Apple Vision Pro, WebKit a ajouté un modetransient-pointerqui n’existe que le temps d’un pincement ; en mars 2024, il était disponible derrière un drapeau, à des fins de test [9].
Le texte, point faible relevé plus haut, est ce que visent les modules. Le module WebXR Layers (Working Draft d’août 2026) définit des calques quad et cylindre composés par le système ; il note que la voie WebGL classique rééchantillonne le contenu au moins deux fois et propose un indice de qualité « text-optimized » [3]. Le module DOM Overlays (Working Draft de septembre 2024) permet d’afficher du HTML pendant une session immersive, y compris sous forme de rectangle flottant dans un casque [4] ; nous ne l’avons pas testé. MDN classe WebXR comme expérimental et hors Baseline [2]. Sur caniuse, au moment de la rédaction, Chrome et Edge de bureau ont un support partiel depuis la version 79, Firefox le livre désactivé par défaut et Safari sur iOS ne le prend pas en charge [7].
Le rendu repose sur WebGL 2, dérivé d’OpenGL ES 3.0 [6], ou sur WebGPU, Candidate Recommendation Draft (septembre 2026) dont les adaptateurs peuvent être demandés compatibles WebXR [5]. Le texte du module Layers que nous avons lu ne définit qu’une liaison WebGL [3], et caniuse indique WebGPU activé par défaut dans Chrome et Edge depuis la version 113, partiel dans Safari depuis la 26 et désactivé par défaut dans Firefox [8]. Pour un outil qui doit aussi tourner sur du matériel modeste, WebGL 2 reste aujourd’hui la base la plus sûre ; notre article voisin traite du rendu de la scène sur GPU intégrés.
Étude de cas : le graphe orbital de Darkmoon
Périmètre et frontière
Chaîne de traitement
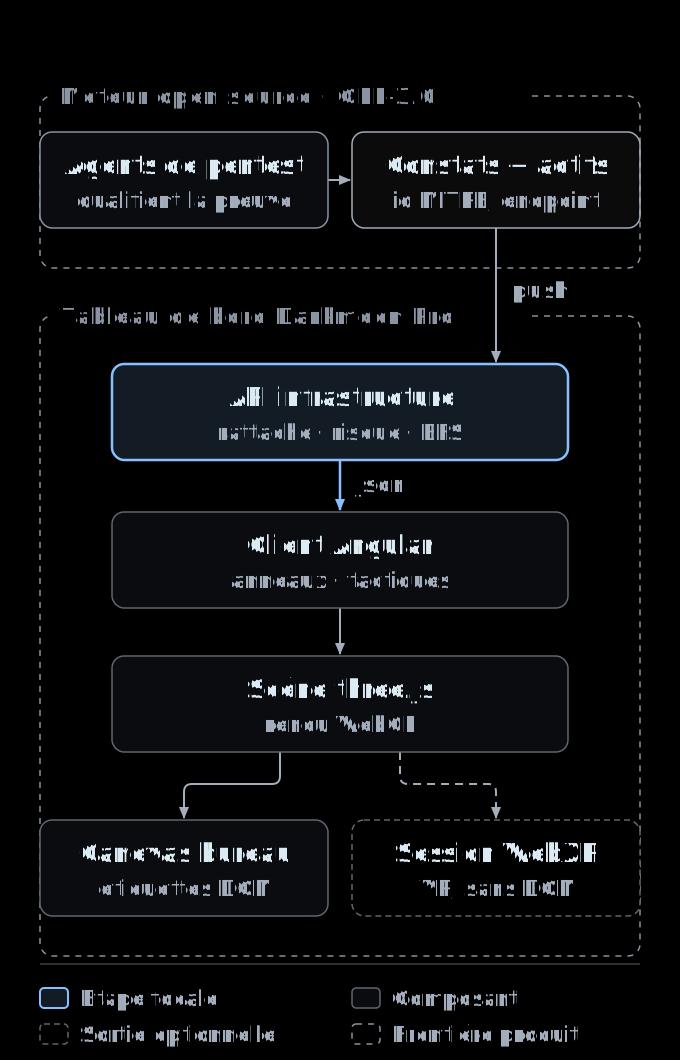
La figure 2 suit les données. Les agents poussent chaque constat avec son actif, son endpoint et sa technique ATT&CK (l’outil d’envoi existe dans le moteur open source). L’API infrastructure du tableau de bord fait ensuite trois choses déterministes : elle reconstruit le rattachement de chaque constat à exactement un actif existant, selon un ordre d’indices fixe (l’endpoint concerné, une fuite d’un magasin de données, l’actif désigné par l’agent, l’hôte et le port, l’application, enfin la cible) sans jamais inventer d’actif ; elle fixe le risque de chaque actif à la sévérité maximale de ses constats ; et elle calcule les chemins d’attaque par parcours en largeur depuis l’entrée exposée à Internet vers chaque actif portant un constat élevé ou critique. Le client web Angular place les actifs sur trois anneaux (données et secrets, applications, exposé à Internet), associe techniques et tactiques, et confie le tout à une scène three.js unique qui s’affiche dans la page ou dans une session WebXR.
Actifs, constats et chemins
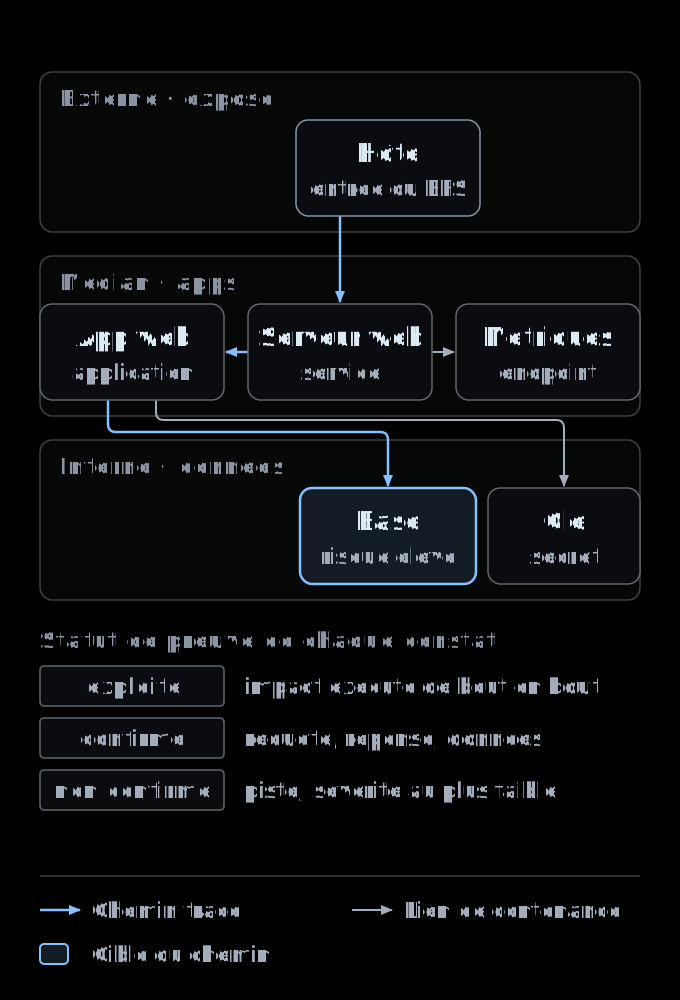
La figure 3 déroule les anneaux en bandes. La disposition est radiale par type : magasins de données, clés, TLS et authentification sur l’anneau interne, applications et endpoints au milieu, hôtes, cible et reste de l’infrastructure sur l’anneau externe. Les arêtes viennent du parent enregistré pour chaque actif découvert : ce sont des relations de contenance (contient, exécute, endpoint), pas des préconditions d’exploit. Le chemin tracé combine deux choses : une chaîne de tactiques (pour chaque tactique présente, le constat au CVSS le plus élevé, ordonné de Reconnaissance à Impact, puis relié par plus courts chemins sur les arêtes) et l’union des plus courts chemins de l’entrée vers chaque actif élevé ou critique. La visite guidée raconte au plus six étapes.
Sur la campagne de référence utilisée pendant le développement, un laboratoire OWASP Juice Shop, le graphe comptait 17 actifs, 14 arêtes et 57 constats (8 critiques, 24 élevés, 21 moyens, 4 faibles), tous dotés d’une technique ATT&CK, 33 confirmés et 24 exploités. C’est un seul petit graphe, loin sous la médiane de 120 nœuds de la revue [25], et c’est la seule échelle à laquelle nous avons observé la vue.
Interaction, accessibilité et vue non immersive par défaut
La vue par défaut est la même scène WebGL vue de face, un disque plat avec contrôles orbitaux : en pratique une carte en 2,5D. Cliquer sur un actif (ou le viser avec le rayon d’une manette en VR) le sélectionne et ouvre un panneau latéral avec ses constats, leur sévérité, leur CVSS, leur technique ATT&CK et leur statut de preuve. Un bouton bascule entre le chemin guidé et l’exploration libre. Côté accessibilité, le composant respecte prefers-reduced-motion (pas d’animation de caméra, pas de particule mobile), annonce les sélections dans une région aria-live, expose aux lecteurs d’écran la liste de tous les actifs avec leur risque et leur nombre de constats, et se pilote au clavier (les flèches parcourent les actifs par risque, Échap désélectionne). Les pages campagne, vulnérabilité et rapport du tableau de bord restent les alternatives non spatiales. Ces choix vont dans le sens des XR Accessibility User Requirements du W3C, qui demandent des alternatives au mouvement et des descriptions d’objets compréhensibles par les technologies d’assistance [10].
3D sur écran et WebXR immersif, tels que construits
Le bouton VR explique pourquoi la VR est indisponible (pas de contexte sécurisé, pas de WebXR, pas de casque) et ne propose « Enter VR » que si isSessionSupported('immersive-vr') renvoie vrai ; la session demande local-floor et bounded-floor en options. Dans le casque, l’utilisateur voit les anneaux, les cercles de sévérité, les marqueurs d’alerte et le chemin d’attaque rouge, et peut sélectionner un actif avec l’une ou l’autre manette. Tout le texte de la vue produit, étiquettes, pastilles de comptage, narration guidée et panneau des constats, est du HTML, et le code masque la couche d’étiquettes pendant la présentation. Telle que construite, la vue immersive est donc une vue d’ensemble spatiale sans texte.
Ce que nous n’avons pas fait
Constats d’ingénierie de l’audit
- Deux implémentations d’une même règle. Le client recalcule rattachement et chemins au lieu d’utiliser les chemins calculés par l’API ; les deux peuvent diverger.
- Des heuristiques réglées sur un laboratoire. Des motifs d’endpoint et certains identifiants d’actifs du client viennent du laboratoire de référence ; les autres cibles se rabattent sur l’actif désigné par l’agent et sur des règles génériques.
- Une table de tactiques réduite. Dix-neuf identifiants de techniques sont associés à huit tactiques, une seule chacun. Les 57 constats de la campagne de référence y figurent ; une technique hors table reste sur le graphe mais sort de la narration. C’est la simplification à tactique unique contre laquelle ATT&CK met en garde [12].
- Le statut de preuve n’est pas dessiné. Les cercles de risque et les chemins suivent la sévérité ; le statut n’apparaît que dans le panneau. Comme le playbook demande aux agents de plafonner les constats non confirmés en sévérité faible, les cibles élevées ou critiques sont en pratique confirmées ou exploitées (toutes l’étaient sur la campagne de référence), mais le graphe ne l’impose ni ne le montre.
- Passage à l’échelle. Un seul moteur de rendu WebGL, ratio de pixels plafonné à 2, petits maillages par actif et étiquettes DOM repositionnées à chaque trame : suffisant pour quelques dizaines d’actifs, non mesuré au-delà. Détail relevé en chemin : three.js ignore
linewidthsous WebGL et WebGPU [42], si bien que le cercle de sévérité plus épais demandé par le code s’affiche sur un pixel.
Hypothèses et protocole pour les tester (travaux futurs)
Rien dans cette section n’a été mené. C’est l’expérience que les résultats ci-dessus appellent selon nous, écrite pour pouvoir être critiquée avant d’être faite.
| Hypothèse | Pourquoi plausible | Ce qui la réfuterait |
|---|---|---|
| H1. Une disposition en anneaux d’exposition fait trouver l’entrée et l’actif de données plus vite qu’un tableau de constats | La position encode l’exposition [19] ; le nœuds-liens favorise la recherche de chemin [18] | Aucun gain de temps ni de justesse face au tableau |
| H2. La 3D sur écran est au moins aussi juste que le casque et plus rapide pour la sélection | Bureau le plus rapide et le plus précis [24] | Casque plus rapide à justesse égale |
| H3. Le casque n’aide sur la structure que pour les grands graphes | L’effet croît avec la taille [21, 22] | Pas d’interaction entre affichage et taille du graphe |
| H4. Afficher le statut de preuve sur les nœuds améliore la priorisation et calibre la confiance | Saillance de l’état de l’automatisation [41] | Mêmes erreurs de classement avec et sans statut |
| H5. Un chemin guidé améliore le briefing d’un non-expert sans dégrader l’analyse d’un expert | Compréhension et projection [32, 38] | Experts plus lents ou moins justes en mode guidé |
Plan. Intra-sujets, contrebalancé, trois conditions : tableau de constats et rapport (référence 2D), vue orbitale sur écran, casque WebXR. Trois groupes de participants analysés à part : pentesters, analystes SOC et décideurs non techniques. Des graphes issus de vraies données de campagne, de tailles croissantes, jamais des constats synthétiques présentés comme réels. Tâches. Identifier le point d’entrée ; tracer un chemin vers un actif de données nommé ; classer les trois constats à corriger en premier ; expliquer le risque à un non-expert en deux minutes. Mesures. Justesse par rapport à une grille établie par deux testeurs indépendants, temps de réalisation, charge NASA-TLX et SUS comme dans les études cyber citées [36], questionnaire de cinétose SSQ [28], questions à l’arrêt sur les trois niveaux d’Endsley [32] et, pour le casque, temps de trame et durée de session. Validité. Préenregistrer hypothèses et analyses, comme l’ont fait des études immersives avec des experts du domaine [27] ; fixer la taille d’échantillon par une analyse de puissance avant le recrutement ; publier les résultats négatifs. Une étude menée par l’éditeur de l’outil n’est pas indépendante : nous publierions le matériel et les données anonymisées pour permettre la réplication.
Les cases n/c de la figure 1 sont les manques que vise ce protocole : aucune étude trouvée ne compare la 2D, la 3D sur écran et le casque sur les mêmes tâches de chemin d’attaque avec des professionnels de la sécurité.
Limites et risques
- Biais de nouveauté. La présence et le flow augmentent en VR [31], [36] ; aucun des deux n’est de la justesse. Une démonstration impressionnante n’est pas une preuve.
- Isolement des outils. Les experts notent que la VR les coupe de leurs outils habituels [36] ; une vue casque ne peut que compléter le poste de l’analyste, jamais le remplacer.
- Confort et inclusion. La cinétose, l’effort physique et la lisibilité du texte limitent la durée des sessions et excluent certains utilisateurs [28], [30], [10]. La voie 2D doit rester complète.
- Surconfiance dans l’automatisation. Un chemin rouge bien net peut sembler plus certain que la preuve ne l’est [41]. Les pistes non confirmées doivent se distinguer visuellement.
- Nouvelle surface d’attaque. Les outils immersifs peuvent introduire leurs propres vulnérabilités [38], et WebXR expose des données de suivi soumises à consentement [1]. Pour un tableau de bord de sécurité, le casque fait partie du modèle de menace.
- Nos propres limites. Un seul petit graphe de référence, aucune mesure en casque, aucune étude utilisateurs. Tout bénéfice reste une hypothèse.
Les pistes que nous envisageons, présentées comme telles : des panneaux de texte en calques quad WebXR [3] pour rendre le panneau des constats lisible dans un casque ; le statut de preuve encodé sur les nœuds et les arêtes ; un client qui consomme les chemins de l’API ; des sessions partagées entre un pentester et un décideur, le cas d’usage vers lequel pointent les études collaboratives [23], [34] ; et une vue de provenance des actions des agents dans le temps, dans l’esprit d’AgentLens [40]. Rien de cela n’est construit.
Ressources complémentaires
- ASCIT31/Darkmoon-Benchmarks : les benchmarks publics de pentest autonome piloté par LLM, menés par l’équipe Darkmoon sur des laboratoires volontairement vulnérables. Leur périmètre est le résultat offensif (ce qui a été trouvé et prouvé, à quel coût) ; ils ne contiennent aucune évaluation de visualisation, de WebXR ni de WebGL, et rien n’y confirme ni n’infirme les affirmations de cet article.
- ASCIT31/Dark-Moon : le moteur open source (GPL-3.0), la CLI et les agents, dont les règles de qualification du statut décrites plus haut.
- L’histoire produit du graphe orbital, la page du graphe d’infrastructure et l’architecture multi-agents qui l’alimente (en anglais).
Méthode de cette étude
Les sources ont été choisies pour leur caractère primaire (standards, articles évalués par les pairs, documentation officielle) et leur accessibilité : chaque référence ci-dessous a été ouverte le 25 octobre 2026, page de l’éditeur ou du dépôt, notice arXiv, ou métadonnées bibliographiques avec résumé (Crossref, OpenAlex, HAL). Quand seul le résumé était disponible, nous ne citons que ce qu’il affirme. Les chiffres de support navigateur viennent de caniuse à cette date et évolueront. L’audit du code a porté sur le composant du tableau de bord et son API (dépôt privé, version de septembre 2026) et sur le playbook open source des agents au commit indiqué ; les chiffres de la campagne de référence ont été comptés dans les fichiers de données qui ont servi à développer la vue. Nous n’avons mené ni étude utilisateurs ni mesure en casque.
Références
- W3C Immersive Web WG. WebXR Device API. Candidate Recommendation Draft, 9 juin 2026. www.w3.org/TR/webxr/
- MDN Web Docs. WebXR Device API. developer.mozilla.org/en-US/docs/Web/API/WebXR_Device_API
- W3C. WebXR Layers API Level 1. Working Draft, 11 août 2026. www.w3.org/TR/webxrlayers-1/
- W3C. WebXR DOM Overlays Module. Working Draft, 24 septembre 2024. www.w3.org/TR/webxr-dom-overlays-1/
- W3C GPU for the Web WG. WebGPU. Candidate Recommendation Draft, 15 septembre 2026. www.w3.org/TR/webgpu/
- Khronos Group. WebGL 2.0 Specification (brouillon d’éditeur). registry.khronos.org/webgl/specs/latest/2.0/
- caniuse.com. WebXR Device API (consulté le 25 octobre 2026). caniuse.com/webxr
- caniuse.com. WebGPU (consulté le 25 octobre 2026). caniuse.com/webgpu
- A. R. Cannon, B. Zachernuk. Introducing Natural Input for WebXR in Apple Vision Pro. Blog WebKit, 19 mars 2024. webkit.org/blog/15162/introducing-natural-input-for-webxr-in-apple-vision-pro/
- W3C APA WG. XR Accessibility User Requirements. Working Group Note, 25 août 2021. www.w3.org/TR/xaur/
- MITRE ATT&CK. Tactiques Enterprise (ATT&CK v20). attack.mitre.org/tactics/enterprise/
- MITRE ATT&CK. T1078 Valid Accounts. attack.mitre.org/techniques/T1078/
- O. Sheyner, J. Haines, S. Jha, R. Lippmann, J. M. Wing. Automated Generation and Analysis of Attack Graphs. IEEE Symposium on Security and Privacy, 2002. www.cs.cmu.edu/afs/cs.cmu.edu/project/calder/www/sp02.html
- X. Ou, S. Govindavajhala, A. W. Appel. MulVAL: A Logic-based Network Security Analyzer. 14th USENIX Security Symposium, 2005, p. 113–128. www.usenix.org/legacy/events/sec05/tech/ou.html
- S. Noel, S. Jajodia. Understanding Complex Network Attack Graphs through Clustered Adjacency Matrices. ACSAC 2005, p. 160–169. acsac.org/2005/abstracts/87.html
- H. S. Lallie, K. Debattista, J. Bal. A review of attack graph and attack tree visual syntax in cyber security. Computer Science Review 35, 100219, 2020. wrap.warwick.ac.uk/id/eprint/131160
- A.-M. Konsta, B. Spiga, A. Lluch Lafuente, N. Dragoni. A Survey of Automatic Generation of Attack Trees and Attack Graphs. arXiv:2302.14479, 2023. arxiv.org/abs/2302.14479
- M. Ghoniem, J.-D. Fekete, P. Castagliola. A Comparison of the Readability of Graphs Using Node-Link and Matrix-Based Representations. IEEE InfoVis 2004. hal.science/hal-00343819
- W. S. Cleveland, R. McGill. Graphical Perception: Theory, Experimentation, and Application to the Development of Graphical Methods. Journal of the American Statistical Association 79(387), 1984. doi.org/10.1080/01621459.1984.10478080
- C. Ware, G. Franck. Evaluating Stereo and Motion Cues for Visualizing Information Nets in Three Dimensions. ACM Transactions on Graphics 15(2), 1996, p. 121–140. scholars.unh.edu/ccom/939
- O.-H. Kwon, C. Muelder, K. Lee, K.-L. Ma. A Study of Layout, Rendering, and Interaction Methods for Immersive Graph Visualization. IEEE TVCG 22(7), 2016. doi.org/10.1109/TVCG.2016.2520921
- J. Kotlarek, O.-H. Kwon, K.-L. Ma, P. Eades, A. Kerren, K. Klein, F. Schreiber. A Study of Mental Maps in Immersive Network Visualization. IEEE PacificVis 2020 (arXiv:2001.06462). arxiv.org/abs/2001.06462
- M. Cordeil, T. Dwyer, K. Klein, B. Laha, K. Marriott, B. H. Thomas. Immersive Collaborative Analysis of Network Connectivity: CAVE-style or Head-Mounted Display? IEEE TVCG, 2017. doi.org/10.1109/TVCG.2016.2599107
- B. Bach, R. Sicat, J. Beyer, M. Cordeil, H. Pfister. The Hologram in My Hand: How Effective is Interactive Exploration of 3D Visualizations in Immersive Tangible Augmented Reality? IEEE TVCG, 2018. doi.org/10.1109/TVCG.2017.2745941
- L. Joos, M. T. Fischer, J. Rauscher, D. A. Keim, T. Dwyer, F. Schreiber, K. Klein. Visual Network Analysis in Immersive Environments: A Survey. arXiv:2501.08500, 2025. arxiv.org/abs/2501.08500
- B. Ens et al. Grand Challenges in Immersive Analytics. CHI 2021. doi.org/10.1145/3411764.3446866
- A. Batch et al. There Is No Spoon: Evaluating Performance, Space Use, and Presence with Expert Domain Users in Immersive Analytics. IEEE TVCG, 2020. doi.org/10.1109/TVCG.2019.2934803
- D. Saredakis et al. Factors Associated With Virtual Reality Sickness in Head-Mounted Displays: A Systematic Review and Meta-Analysis. Frontiers in Human Neuroscience, 2020. pmc.ncbi.nlm.nih.gov/articles/PMC7145389/
- E. Chang, H. T. Kim, B. Yoo. Virtual Reality Sickness: A Review of Causes and Measurements. International Journal of Human-Computer Interaction 36(17), 2020. doi.org/10.1080/10447318.2020.1778351
- J. Novotny, D. H. Laidlaw. Evaluating Text Reading Speed in VR Scenes and 3D Particle Visualizations. IEEE TVCG, 2024. doi.org/10.1109/TVCG.2024.3372093
- G. Makransky, T. S. Terkildsen, R. E. Mayer. Adding immersive virtual reality to a science lab simulation causes more presence but less learning. Learning and Instruction 60, 2019. doi.org/10.1016/j.learninstruc.2017.12.007
- M. R. Endsley. Toward a Theory of Situation Awareness in Dynamic Systems. Human Factors 37(1), 1995. doi.org/10.1518/001872095779049543
- U. Franke, J. Brynielsson. Cyber situational awareness – A systematic review of the literature. Computers & Security 46, 2014. doi.org/10.1016/j.cose.2014.06.008
- A. Kabil, T. Duval, N. Cuppens et al. 3D CyberCOP: a Collaborative Platform for Cybersecurity Data Analysis and Training. CDVE 2018. hal.science/hal-01831965
- A. Kabil, T. Duval, N. Cuppens. Alert Characterization by Non-Expert Users in a Cybersecurity Virtual Environment: a Usability Study. AVR 2020. hal.science/hal-02891940
- N. Delcombel, T. Duval, M.-O. Pahl. Cybercopters Swarm: Immersive analytics for alerts classification based on periodic data. Frontiers in Virtual Reality 4, 2023. doi.org/10.3389/frvir.2023.1156656
- K. Kullman, D. Engel. Interactive Stereoscopically Perceivable Multidimensional Data Visualizations for Cybersecurity. Journal of Defence & Security Technologies 4(3), 2022. doi.org/10.46713/jdst.004.03
- H. Ahmad, F. Ullah, R. Jafri. A Survey on Immersive Cyber Situational Awareness Systems. arXiv:2408.07456, 2024. arxiv.org/abs/2408.07456
- G. Deng et al. PentestGPT: An LLM-empowered Automatic Penetration Testing Tool. arXiv:2308.06782, 2023 (révisé en 2024). arxiv.org/abs/2308.06782
- J. Lu et al. AgentLens: Visual Analysis for Agent Behaviors in LLM-based Autonomous Systems. arXiv:2402.08995, 2024. arxiv.org/abs/2402.08995
- R. Parasuraman, V. Riley. Humans and Automation: Use, Misuse, Disuse, Abuse. Human Factors 39(2), 1997. doi.org/10.1518/001872097778543886
- three.js r186. Documentation du source de LineBasicMaterial (linewidth). github.com/mrdoob/three.js/blob/r186/src/materials/LineBasicMaterial.js
La preuve plutôt que le discours : le benchmark de remédiation Pro (correctifs retestés contre l'exploit) · Darkmoon face aux autres outils de pentest IA.
← Tous les articles