La page d'accueil de dark-moon.org n'a pas d'image d'en-tête. Derrière chaque section tourne une seule scène WebGL : un champ d'étoiles et la Lune, texturée avec des données de la NASA, vers laquelle la page descend à mesure qu'on fait défiler. Ce texte retrace la façon dont cette scène a été construite puis reconstruite en octobre 2026, et le travail d'ingénierie qu'il a fallu pour qu'elle reste utilisable sur des portables de bureau à GPU intégré et sur des téléphones ordinaires. Il s'appuie sur l'historique du dépôt, sur le code tel qu'il est publié sur origin/main au commit 0cd6528(25 octobre 2026) et sur les mesures que nous avons réellement relevées. Ce n'est pas une vitrine : plusieurs chiffres ci-dessous sont peu flatteurs, et certaines questions restent ouvertes.
Périmètre et preuves
0cd6528, le commit déployé en production le 25 octobre 2026. Les expériences abandonnées, ou restées sur d'autres branches, sont nommées comme telles. Chaque mesure indique ses conditions. Nous n'avions aucun appareil bas de gamme physique : ni portable Intel HD/UHD 620, ni téléphone Android d'entrée de gamme. Les chiffres « bas de gamme » viennent d'une seule machine (un Intel Core Ultra 7 356H, dont Chrome désigne le GPU intégré comme « Intel(R) Graphics ») bridée côté CPU et côté GPU. C'est de l'émulation, et nous la traitons comme telle. Le dépôt source du site est privé : les identifiants de commit servent à rattacher chaque affirmation à notre propre historique, pas de liens publics.Mise à jour, 25 octobre 2026 (soir)
0cd6528. Une version publiée le même jour (1b4ba45) a modifié quatre points qu'il évoque : les téléphones de moins de 768 px reçoivent désormais par défaut la vue « cinématique » (?cine=0 la désactive pour la session) ; le casque VR n'est construit qu'une fois le GPU jugé rapide, et un appareil lent qui atteint cette section reçoit directement le tableau de bord ; en mode GPU faible, les rendus de verre sont arrêtés définitivement ; et la carte orbitale ne démarre qu'à l'approche de l'écran, à un ratio de pixels de 0,75 et une image sur trois. Aucune des mesures ci-dessous n'a été prise sur 1b4ba45.Mise à jour, 26 octobre 2026
dad7167). Les appareils puissants rendent en résolution native ; un contrôleur ne peut baisser la résolution interne d'une couche que si des images manquent, mesures à l'appui. Les optimisations identiques au pixel qui ont remplacé ce mode, la méthode qui nous a servi à prédire leur effet sur un téléphone que nous n'avons pas, et les limites de cette méthode sont décrites dans les deux sections qui suivent l'historique.La contrainte : un fond 3D animé sur une page qui doit charger vite
Trois exigences tirent en sens contraire. La première est une règle produit, écrite dans un message de commit le 27 août 2026 (b0c1a04) : rien ne doit s'afficher « avant » le site fini ; la toute première image doit être le résultat final. Ce commit supprimait complètement l'écran de chargement. Le 4 octobre, un écran de chargement est revenu avec un autre rôle : présent dans le HTML statique, il ne se retire que lorsque la scène WebGL a dessiné sa première image (9c2feff), si bien que ce qui apparaît ensuite est la scène finie, jamais une scène à moitié construite. La deuxième est le référencement : les moteurs de recherche sont la première source de visites du site, donc les scores Lighthouse et PageSpeed Insights comptent. La troisième est le matériel de notre public. Darkmoon est un outil de sécurité ; ses prospects ouvrent le site sur des portables d'entreprise, souvent fins, à graphique Intel intégré, et sur des téléphones. La règle que nous nous sommes fixée le 22 octobre est simple : si la scène exige une carte graphique dédiée, nous nous sommes trompés.
Une quatrième contrainte est moins visible. Lighthouse et PageSpeed Insights exécutent Chrome sans GPU : le WebGL y est rastérisé sur le CPU par SwiftShader. Le 4 octobre, le profil de l'audit mobile montrait 8 989 ms de travail sur le thread principal classé « Other », que nous avons attribués aux images WebGL dessinées en logiciel. Une scène bon marché sur un vrai GPU peut couler un score chez un auditeur qui n'en a pas.
La direction artistique comme donnée d'ingénierie
Chaque décision visuelle ci-dessous a un coût GPU, et plusieurs ont changé pour cette raison. Le raisonnement est reconstitué à partir des messages de commit et de nos notes de conception ; quand nous interprétons, nous le disons.
Des montagnes à la Lune
La refonte d'octobre a commencé sur du noir uni : le 1er octobre, le fond WebGL a été retiré (197a065). Il est revenu le lendemain matin (73cae3a) sous la forme de quatre crêtes de montagnes en parallaxe devant un halo de « coucher de soleil », recolorées dans la palette officielle (du Jordy#87BFFF sur la crête lointaine au Neon #2667FF et au Chrysler #3B26CC, jusqu'à un indigo profond au premier plan ; les valeurs de la charte vivent désormais dans lib/brand-colors.ts). Le même jour, le tone mapping a été coupé (79621b2) : ACES tirait chaque couleur de la charte vers le gris, alors que la marque a besoin de ses valeurs hexadécimales exactes à l'écran. Une dizaine de variantes des crêtes se sont succédé ce jour-là (dégradés plats, voiles translucides, crêtes noires opaques) ; le journal des commits les conserve.
Le 22 octobre, les crêtes ont été remplacées par une Lune. La première tentative était notre propre shader plein écran de lancer de rayon sur une sphère (08a35a0). Nos notes de conception la disent jugée lente et trop éloignée de la référence ; elle a été remplacée un quart d'heure plus tard (cd5eb05) par une construction bien plus ordinaire, calquée explicitement sur celle du site 21 Hours on the Moon : une SphereGeometry(1, 128, 128), un matériau Phong avec cartes de normales et de déplacement, une lumière directionnelle montée sur un conteneur derrière la Lune, et une caméra de 50°. Nous avons repris cette structure, aucun de leurs fichiers. Nos textures, d'abord procédurales, sont devenues l'après-midi même le CGI Moon Kit de la NASA, la mosaïque couleur LRO et l'altimétrie LOLA publiées par le Scientific Visualization Studio de la NASA (527ec89), converties par un script du dépôt et créditées danspublic/textures/moon/CREDITS.txt.
Notre lecture de cette journée, que nous n'avons pas mesurée en A/B : la solution « astucieuse » était la plus chère. Un shader plein écran de lancer de rayon sur une sphère s'exécute pour chaque pixel de la fenêtre, à chaque image, ciel vide compris. Une sphère texturée avec un matériau standard n'ombre que les pixels couverts par la Lune, utilise des textures mipmappées pour lesquelles le GPU est conçu, et laisse three.js gérer le frustum et les états.
Composition, lumière et descente
Le cadrage du héros a été validé le 22 octobre, puis inversé le 23 pour placer le limbe en bas à droite, sa courbe montant vers le coin supérieur droit, d'après une référence choisie en revue de conception (e075cd8). Le défilement ne déclenche pas de coupes : cosmos-moon.ts définit des images clés (position de caméra, inclinaison, angle de lumière, poids du détail) à des profondeurs de scroll exprimées en hauteurs d'écran, et le scroll de la page les parcourt via une valeur amortie. Chaque cadrage laisse une zone noire calme pour le texte et une bande de matière détaillée, toujours en contre-jour, si bien que le sol non éclairé tombe dans le même noir que le ciel. Un seul noir pour les ombres et le ciel est une décision explicite, notée dans le code le 22 octobre, et elle est aussi économique : pas de lumière d'appoint, pas de terme ambiant à calculer sur la face nocturne.
Le bloom a été retiré. L'UnrealBloomPass transformait le centre de la scène en soleil éblouissant sur le vrai GPU d'un membre de l'équipe, alors que les captures headless ne le montraient jamais ; il a été isolé en direct grâce à un interrupteur ?diag=nobloom. Le commentaire laissé dans cosmos-background.tsx en donne la raison : le bloom amplifie les pixels les plus clairs et se rastérise différemment selon le GPU et le pilote. Le retirer a aussi supprimé toute une chaîne de post-traitement plein écran. Le grain film est une tuile de 256 px générée une fois sur un canvas 2D et déplacée par une animation CSS, sous le contenu : aucune passe GPU par image.
Interprétation. Nous lisons le résultat comme une image de l'autonomie en mouvement : une caméra qui avance sans qu'on la pilote, une lumière qui vient d'au-delà de l'horizon, une surface révélée progressivement. Cette lecture est la nôtre ; les commits consignent des cadrages, des angles de lumière et des valeurs de couleur, pas un manifeste.
Architecture du pipeline de rendu
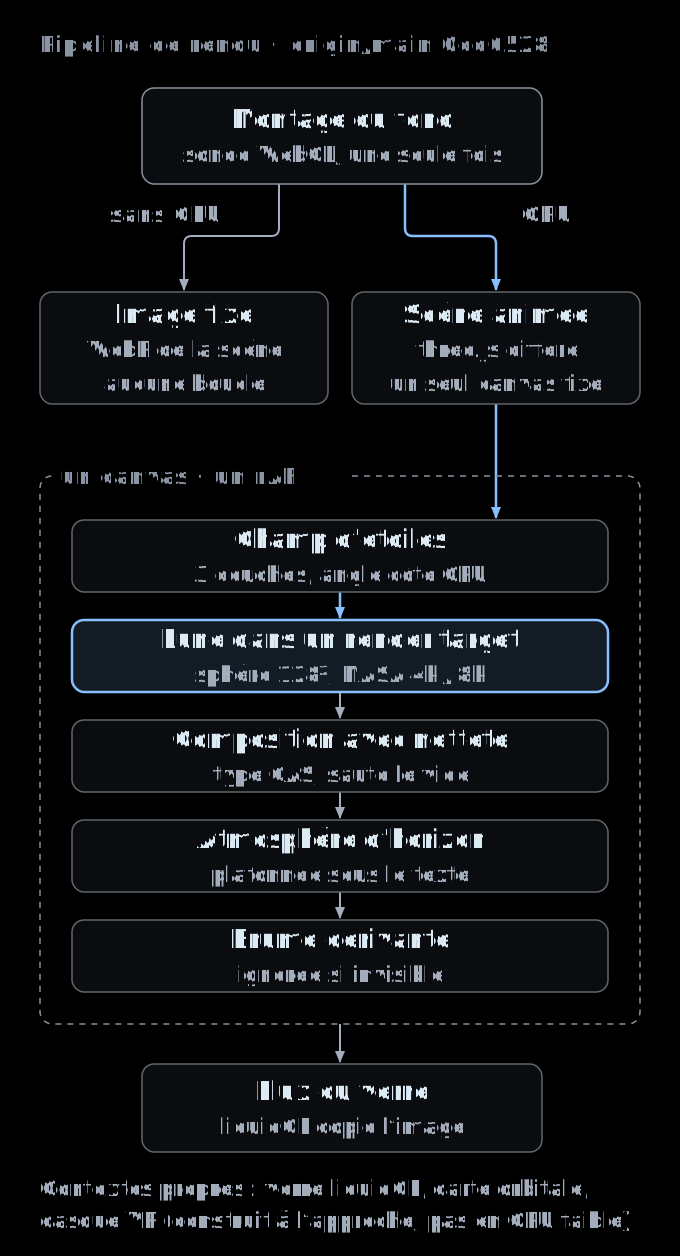
components/blocks/cosmos-mount.tsx, cosmos-background.tsx, cosmos-moon.ts à 0cd6528.Démarrage différé et canvas unique
La scène est un composant client chargé via next/dynamic sans rendu serveur : three.js n'est pas dans le JavaScript initial. Une indication de préchargement de son chunk a été retirée le 4 octobre, parce qu'elle entrait dans le graphe de LCP simulé de Lighthouse (cdb389a). Avant toute construction,lib/webgl.ts sonde une fois par page la présence d'un WebGL matériel : un contexte 1×1 demandé avecfailIfMajorPerformanceCaveat, dont la chaîne de rendu est ensuite comparée aux rastériseurs logiciels (SwiftShader, llvmpipe), car Chrome headless fournit un contexte SwiftShader même avec ce drapeau. Le résultat est mis en cache : sur les pilotes Direct3D 12, chaque contexte de test coûtait environ une demi-seconde, et deux composants le demandaient (1151033). Sans WebGL matériel, la page affiche une image fixe : un poster WebP exporté de la vraie scène, en 1920×1080 et 720×1440 pixels, sans aucune boucle de rendu (132c010).
Avec un GPU, un seul canvas fixe plein écran dessine tout le fond. Le renderer est créé avec depth: false(rien dans la scène n'écrit de profondeur : le tampon de profondeur multi-échantillonné était effacé à chaque image pour rien) et sans preserveDrawingBuffer (44e2029). Le blog, les pages légales, la page confiance et la page investisseurs ne montent pas la scène du tout ; la démonter, plutôt que la masquer, libère le GPU (ada5168). Une perte de contexte WebGL incrémente un compteur qui détruit puis reconstruit la scène sur un canvas neuf.
Les passes
- Étoiles. Jusqu'à trois couches
THREE.Points(4 200 points par couche sur ordinateur, 2 400 sur téléphone, une seule couche de 1 200 en rendu logiciel), en mélange additif, avec un vertex shader qui élimine les étoiles proches et borne la taille des points entre 2 et 6 px. - Lune. Une scène à part, rendue dans un render target à la taille du drawing buffer. Le matériau est un
MeshPhongMaterialmodifié viaonBeforeCompilepour ajouter des octaves de détail dont le poids dépend du grossissement de la texture à chaque pixel (fwidthdes coordonnées de texture) : les gros plans restent nets sans bruit de minification. À la distance du héros, le poids du détail vaut exactement zéro et une branche sur uniforme le saute (992223a). - Composition avec netteté. Le render target est affiché via une passe de netteté adaptative au contraste, inspirée d'AMD FidelityFX CAS. Elle saute les pixels vides, dont la sortie est exactement nulle (
91f77c7). - Atmosphère d'horizon. Une ligne fine calculée par pixel à partir de la hauteur du rayon de vue au-dessus de la sphère ; les fragments inférieurs à un dix-millième de pas de couleur sont ignorés (même commit : le temps GPU de l'atmosphère a été à peu près divisé par deux). Sa luminosité est plafonnée derrière le texte clair (voir plus bas).
- Brume. Une passe plein écran, entièrement sautée tant que son opacité est nulle.
- Flux du verre. Les cartes en verre liquide (la bibliothèque liquidGL, sous licence MIT, intégrée au dépôt avec nos correctifs) copient le canvas juste après son dessin, dans la même image : c'est ce qui a rendu
preserveDrawingBufferinutile.
Trois autres contextes WebGL existent sur l'accueil : celui de la bibliothèque de verre liquide, la carte orbitale d'infrastructure du produit (le même moteur three.js que celui décrit dans notre article sur le graphe orbital, en pause hors écran) et, depuis le 25 octobre, un casque VR procédural qui introduit le tableau de bord du produit. Le module du casque est importé quand sa section arrive à moins de deux écrans, ou plus tôt, sur un temps mort, une fois que le fond a prouvé que le GPU est rapide ; il n'est jamais construit une fois la page passée en mode GPU faible (section suivante).
Textures et mémoire GPU
La Lune utilise un albédo gris de 4096×2048, des normales de 4096×2048, une carte de hauteur de 2048×1024 et deux cartes de détail répétables de 1024×1024. Le décodage se fait hors du thread principal viacreateImageBitmap. Là où cela en vaut la peine, l'albédo et les normales en 8192×4096 remplacent les cartes 4k, et l'essentiel du travail de performance de fin octobre a consisté à le faire sans gel visible :
- Les cartes 8k ne se chargent qu'en WebGL2, avec un
MAX_TEXTURE_SIZEd'au moins 8192, si l'appareil annonce au moins 4 Go de mémoire (ou ne l'annonce pas), jamais sur iPhone ni iPad, et seulement quand un texel 4k couvrirait plus de 1,25 pixel physique à la distance actuelle de la caméra. - Une carte RGBA de 8192×4096 représente 134 Mo de pixels ; un seul appel
texImage2Dprovoquait un à-coup de 200 ms. L'image est désormais téléchargée, décodée et découpée en bandes de 32 lignes dans un worker, le stockage de la texture est alloué une fois avectexStorage2Det une chaîne de mipmaps complète, et une bande (environ 1 Mo, moins de 3 ms) est envoyée par image quand la page est immobile depuis 0,8 s (ecdf30f,5af11ad). - L'albédo est gris : il vit dans une texture à un canal
R8, lue en.rrr. Le stockage avec mipmaps passe de 180 à 45 Mo, avec un héros rendu identique à 100 % à la version RGBA8 (dd88e7d). - La première écriture dans un stockage fraîchement réservé oblige le pilote à l'engager : pour les deux cartes 8k, environ 180 Mo, un blocage GPU mesuré entre 150 et 170 ms sur l'iGPU Intel (le passage en R8 a ramené à lui seul la part de l'albédo de 100–130 ms à 50 ms au plus). Le stockage est désormais réservé dès le tout premier rendu, et l'écran de chargement ne se retire qu'une fois signalé un
fenceSyncposé après cette réservation, interrogé à chaque image avec un plafond de 1,5 s (dd88e7d). Le coût s'est déplacé sous le chargement, qui reste affiché 0,35 à 0,45 s de plus sur les appareils éligibles. - Les shaders sont compilés une scène par image (Lune, netteté, atmosphère, brume) au lieu d'un bloc d'environ une seconde (
1151033). Sur le backend Direct3D 12 d'ANGLE, nous avons constaté que la compilation asynchrone n'aidait pas pour la Lune : l'interrogation de fin de compilation bloquait aussi longtemps que la compilation.
Une image : scroll, état, cadence, dessin
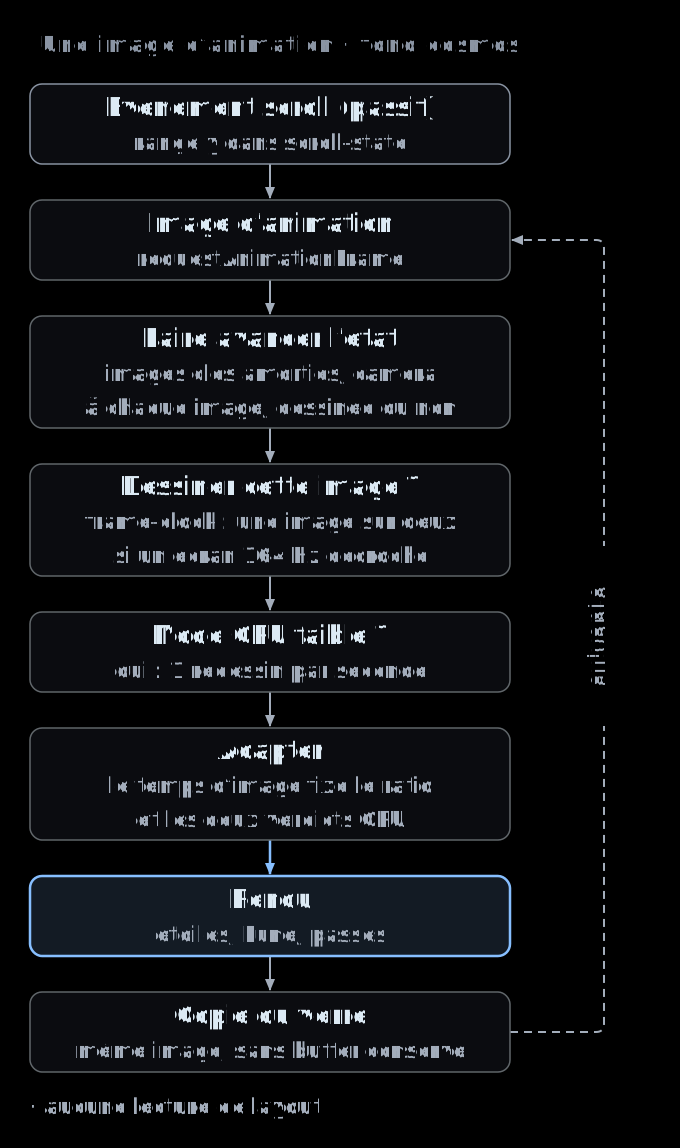
lib/scroll-state.ts, lib/frame-clock.ts, components/blocks/cosmos-background.tsx à 0cd6528.La position de scroll n'est jamais lue dans la boucle. lib/scroll-state.ts la tient à jour depuis un écouteur de scroll passif, la taille de la fenêtre depuis un écouteur de redimensionnement et la hauteur du document depuis un ResizeObserver. Lire window.scrollY dans un rappel d'image force un calcul de style et de mise en page quand un autre script vient d'écrire dans le DOM ; sur l'accueil mobile, cela représentait environ 730 ms de layout forcé pendant un scroll de sept secondes, entièrement attribués à la boucle du fond (ce17438, 5bbe0d1). Les autres effets liés au scroll ont été regroupés sur un ordonnanceur commun qui exécute toutes les lectures, puis toutes les écritures (lib/frame-rw.ts).
La descente suit le scroll via une valeur amortie (sv += (cible − sv) × min(1, dt / 140), avec dten millisecondes) : un coup de molette devient un mouvement de caméra plutôt qu'un saut. L'horloge d'images partagée (lib/frame-clock.ts, 11bb5fe) ne change rien sur un écran 60 Hz. Sur un écran de 120 à 165 Hz dont le GPU manque plus de 15 % des images sur deux secondes, le fond et la carte orbitale dessinent une image sur deux, soit 82 Hz réguliers sur une dalle 164 Hz au lieu d'un 60–164 irrégulier, et la décision tient pour toute la visite.
// lib/frame-clock.ts (extrait, 0cd6528)
const s = [...iv].sort((a, b) => a - b), base = s[Math.floor(s.length * 0.2)]; // the refresh interval
if (base < 11) {
  const missed = iv.filter((x) => x > base * 1.5).length / iv.length;
  if (missed > 0.15) div = 2;
}
Qualité adaptative pour GPU intégrés et téléphones modestes
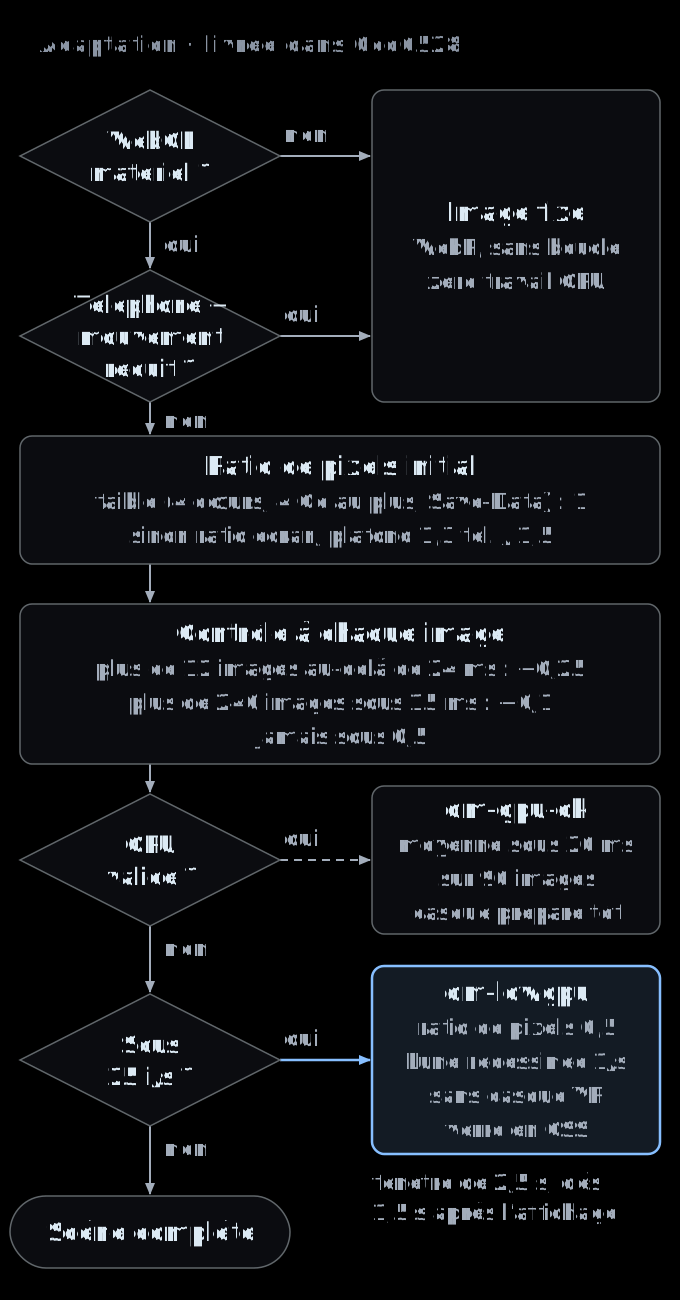
components/blocks/cosmos-background.tsx, cosmos-mount.tsx, vr-showcase/vr-showcase.tsx à 0cd6528.D'abord le ratio de pixels
Le coût des fragments croît avec le carré du ratio de pixels : c'est le premier levier. Le fond ne dépasse jamais 1,5 sur ordinateur ni 1,3 sur téléphone, quoi qu'annonce l'écran. Un appareil qui annonce un hardwareConcurrency de 4 ou moins, un deviceMemory de 4 Go ou moins, ou la préférence Save-Data démarre à 1. Ensuite la boucle se mesure elle-même : plus de 12 images au-delà de 24 ms font baisser le ratio de 0,25, jusqu'à 0,5 au pire ; plus de 240 images sous 15 ms le remontent de 0,1, jamais au-delà du point de départ. Une machine rapide ne bouge jamais. Ces signaux sont grossiers par conception :deviceMemory est arrondi à une puissance de deux, exposé seulement en contexte sécurisé et pas du tout par Safari, ce qui explique précisément qu'iOS ait eu besoin d'une règle à part (voir les bugs plus bas).
Deux verdicts
La boucle émet aussi deux verdicts pour toute la page. dm-gpu-ok se déclenche après 90 images dessinées en moyenne sous 20 ms ; alors seulement l'extra le plus lourd, le casque VR, est préparé en avance (sinon il attend que sa section approche).dm-lowgpu se déclenche quand la moyenne sur une fenêtre de 2,5 secondes, qui commence 1,5 s après l'affichage de la scène (pour que les à-coups du chargement ne décident jamais), passe sous 25 images par seconde, ou quand la scène reste lente au ratio minimal. Le plafond de 30 images par seconde d'un mode économie d'énergie est volontairement au-dessus de ce seuil : ce n'est pas un GPU faible. En mode GPU faible, le fond passe à un ratio de pixels de 0,5 et ne se redessine qu'une fois par seconde au plus, le casque VR n'est pas construit (ou est libéré), et les cartes en verre liquide se replient sur un simple voile givré en CSS. La page continue de défiler au rythme que tient le compositeur.
Le casque a son propre palier allégé pour les mêmes signaux d'appareil faible : pas d'anticrénelage,MeshStandardMaterial au lieu de MeshPhysicalMaterial (pas de vernis), pas de passe de grain et un ratio de pixels plafonné à 0,9 au lieu de 1,25. Dans tous les paliers, ses programmes sont compilés à l'avance avec compileAsync de three.js, et son propre contrôle du temps d'image baisse le ratio de 0,15 après une série d'images au-delà de 22 ms, jusqu'à 0,6 au pire ; un GPU encore lent à ce niveau fait passer la page en mode GPU faible.
Remplacé le 26 octobre
0cd6528. Depuis dad7167, dm-lowgpu n'est plus qu'un signal : rien n'est retiré, figé ni redessiné une fois par seconde à cause de lui. Le palier allégé du casque a disparu (anticrénelage, grain, brume et coque physique sur tous les appareils, iPhone compris), et le fond ne démarre plus à 1 sur un appareil « faible » et ne baisse plus son ratio de pixels ; les plafonds de 1,5 sur ordinateur et 1,3 sur téléphone restent. Ce qui a remplacé ces règles est décrit plus bas.Core Web Vitals avec un fond WebGL
Comme les auditeurs n'ont pas de GPU, Lighthouse mesure le chemin de l'image fixe, pas la scène animée. Ce n'est pas une astuce : c'est exactement ce que reçoit un visiteur sans GPU. La mesure du 4 octobre, avant et après les commits « WebGL logiciel » de ce jour-là, est l'effet le plus net de tout cet historique.
| Lighthouse 13.4, accueil | Avant (9c2feff) | Après (même jour) |
|---|---|---|
| Score performance mobile | 65 | 98 |
| LCP mobile | 3 265 ms | 2 355 ms |
| TBT mobile | 1 382 ms | 38 ms |
| Thread principal mobile, « Other » | 8 989 ms | 1 103 ms |
| Score performance desktop | 92 | 100 |
| TBT desktop | 199 ms | 0 ms |
Conditions : export de production servi en local, Lighthouse 13.4.0 en throttling simulé, Chromium headless sans GPU, un passage chacun, à 22 minutes d'intervalle. La scène de l'époque était celle des crêtes, pas la Lune. Le build « après » a été consigné sous un identifiant de commit qui n'existe plus (notre historique local a été réécrit plus tard ce jour-là pour retirer des fichiers parasites) : nous pouvons nommer les commits faits entre les deux passages (dont 4db0137, d8ff66a, cdb389a, 132c010 et9f4c525 pour la carte orbitale), pas un SHA unique. Avec un passage de chaque côté, c'est l'ampleur de l'effet qui le rend crédible, pas sa précision.
L'écran de chargement est le premier grand rendu de la page : son logotype est l'élément LCP. Lors de sa refonte du 25 octobre, il apparaissait brièvement en fondu depuis une opacité nulle, ce qui reportait le LCP sur le héros quelques secondes plus tard ; la release a supprimé ce fondu (0cd6528). Dans le contrôle qualité qui a précédé cette release, les passages Lighthouse mobile (throttling simulé, sans GPU, deux passages par build) donnaient un LCP de 3 761 et 3 462 ms pour le build de production précédent (fbc57bd) et de 3 460 et 3 461 ms pour la release. Le TBT a évolué dans l'autre sens, de 121–125 ms à 157–166 ms, et le CLS est resté inférieur ou égal à 0,0001. Autrement dit : la release n'a pas dégradé le LCP, elle ne l'a pas amélioré non plus, et elle a ajouté environ 35 ms de temps de blocage simulé. web.dev classe un LCP entre 2,5 et 4 s dans la zone « à améliorer », un seuil prévu pour le 75e centile de chargements réels ; une valeur de laboratoire d'environ 3,5 s est un signal d'alerte, pas un verdict. Les séries du 4 et du 25 octobre ne sont pas directement comparables (scène, serveur et outillage différents), mais l'écart entre un LCP mobile de 2,4 s alors et d'environ 3,5 s aujourd'hui est assez grand pour être signalé, et nous n'en avons pas isolé la cause. C'est une question ouverte, pas un résultat. Cet article n'utilise aucune donnée terrain (CrUX) pour cette page.
Le décalage de mise en page reste quasi nul, car le canvas est fixe, plein écran et démarre transparent ; il apparaît en fondu sur le noir du chargement. Pour la latence d'interaction, notre rapport de banc interne du 23 octobre mesurait les clics sur la carte orbitale, le menu et le clavier à 48 ms ou moins sur l'iGPU Intel : une mesure de laboratoire, pas l'INP d'utilisateurs réels.
Mouvement réduit et lisibilité
prefers-reduced-motion: reduce est respecté à deux niveaux. Sur téléphone, le fond est remplacé par l'image fixe : aucun contexte WebGL, aucune boucle. Sur un écran plus grand, la scène est encore rendue, car elle porte les couleurs de la page, mais elle se fige : l'angle des étoiles et l'horloge restent à zéro, la Lune prend immédiatement ses états d'images clés au lieu de les interpoler, sa lente rotation s'arrête, la brume ne dérive plus et la scène du casque VR n'est pas construite (le tableau de bord s'affiche tel quel). Le passage aux cartes 8k est aussi désactivé sous mouvement réduit, ce qui évite un travail mémoire pour un effet que le lecteur a demandé à minimiser.
La lisibilité posait son propre problème d'ingénierie. La ligne d'horizon de la Lune est l'élément le plus lumineux de la scène, et le texte blanc la traverse pendant le défilement. Le commit 5ffad15(23 octobre) construit, par tranches d'au plus 4 ms pendant les temps morts, une carte basse résolution en coordonnées du document indiquant où se trouve le texte clair (cellules de 8 px, adoucies), et le shader d'atmosphère maintient la ligne sous la luminance dont chaque texte a besoin pour un contraste WCAG de 7:1 (4,5:1 pour les grands textes), ou le meilleur possible au-dessus d'un plancher pour le texte gris. Mesuré sur les pixels rendus en 72 positions de scroll de l'accueil desktop à 1440×900, les lignes de texte en échec du niveau AA à cause de l'horizon sont passées de 148 à 5 (dont deux non reproduites en relance isolée) ; en DPR 1,5 de 55 à 0 ; sur un téléphone 390×844 en DPR 3 de 11 à 0. Loin du texte, la ligne est inchangée. Le canvas lui-même est aria-hidden : il ne porte aucune information absente du texte.
Bugs propres à certains GPU, et comment nous les avons reproduits
Les bugs les plus difficiles de ce projet n'apparaissaient que sur du matériel que nous n'avions pas sous la main. Chacun n'a été corrigé qu'après avoir été reproduit.
- Étoiles écrasées sur les GPU Apple (
27ca6be, 4 octobre). La rotation des étoiles était calculée dans le vertex shader commetime × 0.015, avectimeen secondes depuis l'epoch, soit environ 2,7×10⁷ radians. Les GPU de bureau réduisaient l'argument correctement ; sur un iPhone, une page de diagnostic qui exécutait le shader et relisait le résultat a mesurécos/sinà 0,001 au lieu de −0,166/−0,986 : la matrice de rotation était quasi nulle et toutes les étoiles tombaient sur un seul point (10 pixels allumés au lieu de 509). L'angle est désormais calculé sur le CPU en double précision et ramené entre 0 et 2π. Notre première hypothèse (l'iPhone recevait l'image fixe) était fausse, et la modification de la sonde faite sur cette hypothèse (d007115) a été annulée. - Le temps epoch en float32, encore. La brume de la première Lune se figeait en rectangles pour la même raison ; l'horloge de son shader est désormais bouclée (
performance.now() % 3600, dans08a35a0). - Une traînée lumineuse verticale sur le GPU intégré d'un HP EliteBook. Les étoiles très proches de la caméra avaient un
wminuscule en espace de découpe et une taille de point énorme, que ce GPU étalait sur toute une colonne. Le vertex shader élimine désormais tout ce qui est à moins de 560 unités et borne la taille des points à 6 px. Les commentaires decosmos-background.tsxgardent la trace des deux tentatives nécessaires. - Un halo qui sautait sur un écran Windows à 125 % (
b0c1a04, août). Une uniforme de résolution était passée en pixels CSS alors quegl_FragCoordest en pixels du framebuffer : en DPR 1,25, le halo se rendait à 40 %/55 % de l'écran au lieu du centre. - Un iPhone 14 qui rechargeait trois fois puis affichait « Application error » (
6aed015, 23 octobre). Safari n'expose pasnavigator.deviceMemory: notre seuil « au moins 4 Go » laissait passer les cartes 8k, soit environ 225 Mo de stockage GPU plus deux bitmaps décodés de 128 Mo en sus du reste, au-delà de ce qu'iOS accorde à l'onglet. iPhone et iPad gardent désormais les cartes 4k. Ce plantage a été signalé depuis l'iPhone 14 d'un membre de l'équipe (un iPhone 16 Pro Max n'était pas touché) ; nous ne l'avons pas mesuré nous-mêmes. - Une compilation de shader de 115 ms à la première pause du scroll (
fbc57bd, 24 octobre). La bibliothèque de verre compilait son programme de lentille de façon synchrone la première fois que le lecteur s'arrêtait. AvecKHR_parallel_shader_compile, la bibliothèque corrigée interrogeCOMPLETION_STATUS_KHRà chaque image et bascule sur le programme une fois lié ; sans l'extension, elle garde l'ancien chemin. Le même commit a placé le canvas du verre dans un emplacement réservé, car l'insérer parmi les enfants du body décalait les correspondances:nth-childet recalculait le style de la page (25 à 27 ms, désormais 0,1 ms).
Mesurer sans matériel bas de gamme
Notre banc pilote un Chrome Windows natif via le protocole DevTools depuis WSL. Le 25 octobre, Chrome était lancé avec --force_low_power_gpu --use-angle=d3d11 pour rendre sur le GPU intégré Intel, ce que chaque ligne de résultat confirme via WEBGL_debug_renderer_info. La page était ouverte en 1536×864 pixels CSS avec un facteur d'échelle de 1,25. Après le chargement, six secondes d'attente et un cran de molette, un script faisait défiler la page par programme, un scrollTo par image d'animation, sur des segments fixes (le héros, la scène du casque VR, la plongée dans le tableau de bord, puis toute la page à 700 ms par hauteur d'écran), en relevant l'intervalle entre images d'animation.
Deux freins approchent des machines plus faibles. Le CPU est ralenti par la commande DevToolsEmulation.setCPUThrottlingRate (×4 ou ×6). Le GPU ne peut pas être ralenti ainsi : un second onglet sur le même GPU exécute donc, à chaque image, 24 passes plein écran d'un shader très calculatoire. Calibrée avec une charge GPU fixe dans un troisième onglet, cette contrainte laissait 40 passes par seconde contre environ 360 seul, soit environ 1/9 du débit du GPU. Nous appelons « émulation bas de gamme » cette charge combinée à un CPU ×4. Ce n'est ni un Pentium, ni un Iris Xe, ni un téléphone Android d'entrée de gamme : le compositeur n'est pas ralenti, la mémoire et la bande passante GPU ne sont pas réduites, et partager un GPU avec un autre onglet n'équivaut pas à en avoir un plus petit.
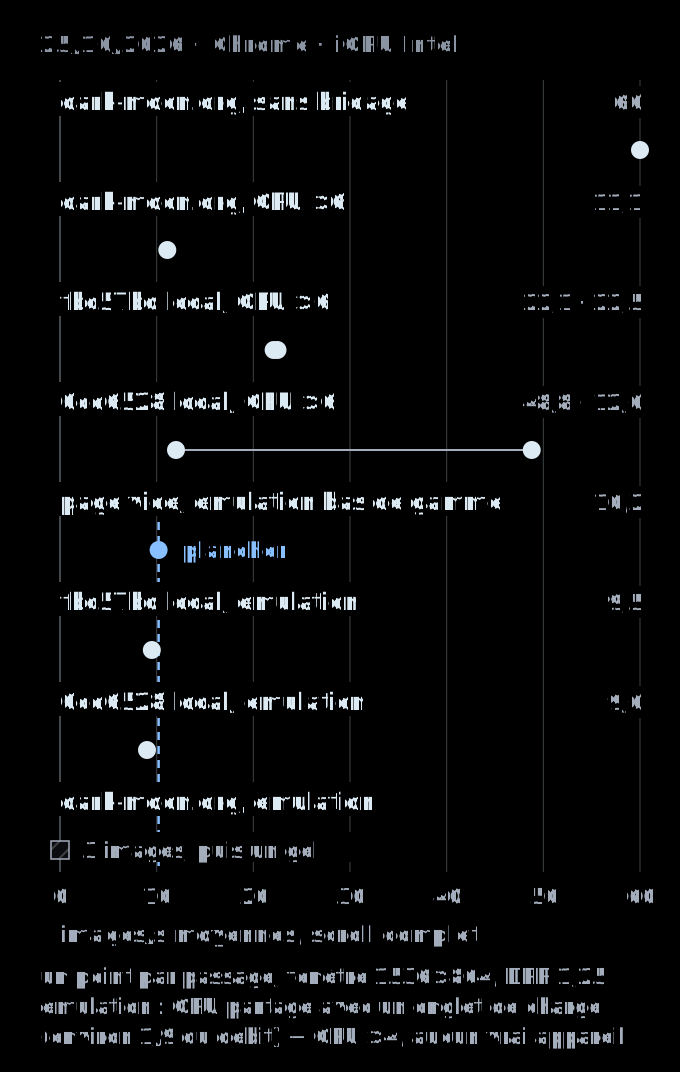
0cd6528 ; builds locaux de fbc57bd et 0cd6528 servis sans cache), selon le protocole décrit ci-dessus. Valeurs mesurées ; un point par passage.| Passage (25/10/2026) | Images | i/s moy. | p50 | p95 | p99 |
|---|---|---|---|---|---|
| dark-moon.org, sans bridage, toute la page | 1332 | 60,0 | 16,7 ms | 16,9 ms | 17,4 ms |
| dark-moon.org, sans bridage, scène VR | 539 | 59,9 | 16,7 ms | 16,9 ms | 17,4 ms |
| dark-moon.org, CPU ×6, toute la page | 247 | 11,1 | 66,8 ms | 216,5 ms | 266,5 ms |
| dark-moon.org, émulation bas de gamme, toute la page | 3 | 0,0 | 316,6 ms | 156 s | 156 s |
| page vide, émulation bas de gamme | 50 | 10,2 | 100 ms | 116,7 ms | 200 ms |
Ce que nous tirons de ces passages, et ce que nous n'en tirons pas :
- Ce GPU intégré récent, non bridé, tient 60 images par seconde, la fréquence de la dalle pendant ce passage (intervalle médian 16,7 ms), sur toute la page, scène VR comprise, avec un p99 de 17,4 ms : une seule image au-delà de 25 ms sur 1 332. Un seul passage ; cela ne dit rien d'un iGPU plus ancien.
- Avec un CPU ralenti six fois, les résultats ne sont pas assez stables pour comparer des builds. Deux passages du même build de release ont donné 48,8 et 12,0 images par seconde ; le build précédent, 22,1 et 22,5. Nous n'affirmons pas que la release est plus rapide ou plus lente sous pression CPU.
- L'émulation bas de gamme ne départage pas les versions en régime établi, car c'est l'émulation elle-même qui limite : une page noire vide atteint 10,2 images par seconde, et les deux builds locaux défilent à 9,0–9,5. Elle révèle en revanche le début de la visite. Dans une trace seconde par seconde du build de production précédent (
fbc57bd) sous la même émulation, des tâches longues allant jusqu'à 4,8 s reviennent autour du moment où la scène s'affiche, environ 20 s après la navigation. Sur la production, un passage du scroll scripté de toute la page, qui commence bien après le chargement, a obtenu trois images puis un gel d'environ 156 s. Nous n'avons pas reproduit ce gel : le build local du même commit défilait à 9,0 images par seconde sous la même émulation ; nous le rapportons donc comme une observation isolée et inexpliquée, pas comme le comportement de la release. - Sur un tel appareil, le verdict GPU faible arrive tard. Sur la production en émulation,
dm-lowgpus'est déclenché environ 34 s après le début de la navigation (un passage, interrogé une fois par seconde) ; la page au repos ne recevait ensuite que 0,3 image d'animation par seconde : le mode GPU faible allégeait la scène, sans rendre fluide cette machine émulée. Sur la même machine sans bridage, il ne s'est jamais déclenché, et la page au repos tournait à 60,3 images par seconde.
Deux jours plus tôt, notre rapport de banc du 23 octobre comparait le travail de fluidité des 22 et 23 octobre à son point de départ, sur la même machine, avec la dalle du portable à 164 Hz (1707×1067, DPR 1,5, moyenne de deux passages alternés). Pendant dix scrolls successifs, les images au-delà de 25 ms passaient de 86 à 3,5 et le p99 de 69,8 à 21,2 ms ; sur le héros immobile, de 27,5 à 3 images, le temps GPU du fond par image passant de 6,8 à 2,1 ms. Le même rapport précise qu'à 60 Hz les deux versions tenaient déjà 60 images par seconde avec un p99 d'environ 17 ms : les gains portaient sur les hautes fréquences et les blocages, pas sur la moyenne.
Historique et compromis : ce que nous avons gardé, ce que nous avons abandonné
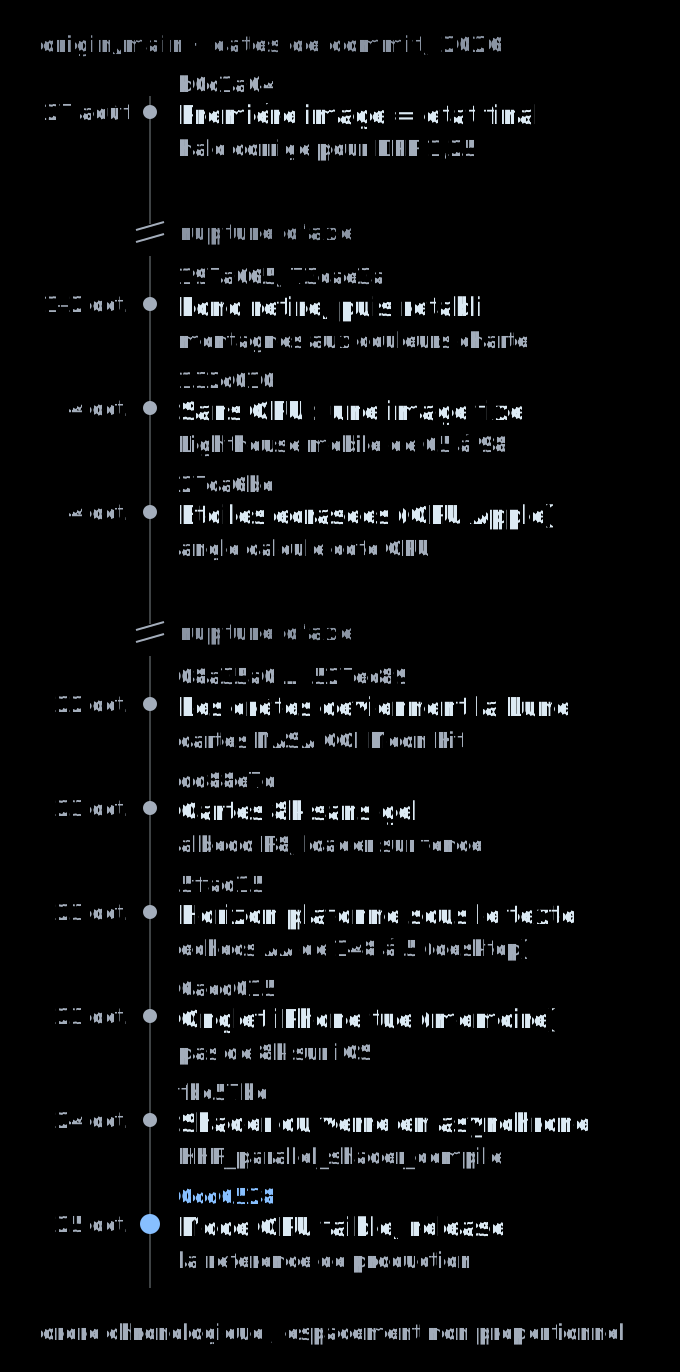
git log origin/main du dépôt du site, dates de commit.Décisions essayées puis annulées, avec leurs raisons telles qu'elles ont été consignées :
- Le bloom : retiré pour ses résultats dépendants du GPU (voir plus haut). Un plan de nébuleuse et une grande sphère d'atmosphère restent aussi dans le code derrière des drapeaux de diagnostic, désactivés par défaut.
- Une correction de précision de profondeur pour les crêtes (plan proche 0,1 → 2, 1 200 segments ;
78c28ab) supprimait le z-fighting sur les crêtes, mais a été jugée régressive visuellement et annulée (bd60b75) ; le correctif conservé est un polygon offset sur les seules bandes de reflet (4174139). Le correctif le moins coûteux était aussi celui qui préservait le rendu. - La Lune en lancer de rayon plein écran (
08a35a0) : remplacée le matin même par une sphère texturée, pour la vitesse et la fidélité. - Des lettres en verre pour le logotype du héros (
dba8816) : annulées (8e05e3e). - L'anticrénelage de la carte orbitale : SMAA et FXAA ont été comparés à une référence MSAA ×8 dans notre rapport du 23 octobre ; tous deux avaient une erreur de contour supérieure au MSAA ×4, qui a été conservé.
- Des expériences jamais arrivées en production : des villes procédurales et un terrain érodé pour la vue infrastructure, et plusieurs directions artistiques, tous conservés sur des branches d'archive. Un mode « cinématique » pour téléphone existait dans le code de
0cd6528derrière le paramètre?cine=1; la version suivante,1b4ba45, en a fait le défaut sur téléphone (voir la note de mise à jour en tête d'article).
Le compromis accepté le plus consciemment est l'écran de chargement. Réserver le stockage 8k sous lui, et ne le retirer qu'une fois cette mémoire engagée par le GPU, l'allonge de 0,35 à 0,45 s sur les appareils éligibles, en échange de l'absence de gels de 100 à 280 ms pendant la visite. Ce choix est réversible en un commit (dd88e7d).
Deuxième passe : chaque visuel partout, les mêmes pixels pour moins de travail
Le soir même de la release, le responsable du site a posé une règle qui contredisait une partie de ce que nous venions de livrer : ne jamais retirer ni figer un visuel sur un appareil faible, et ne jamais baisser la résolution d'office. Les appareils puissants reçoivent la résolution native ; un appareil faible peut voir baisser la résolution interne d'une couche seulement quand il manque, de façon mesurée, son budget d'image, et seulement tant qu'il le manque. Le mode GPU faible enfreignait cette règle par construction : il masquait le casque, figeait la Lune et dégradait le casque, si bien qu'un visiteur sur un matériel modeste voyait une autre page. Il se trompait aussi : une fois, sur une machine rapide dont le lecteur s'était mis à défiler tout de suite, les images du chargement ont été assez lentes pour que le casque soit retiré. Nous avons supprimé ce mode (dad7167) et gardé seulement les économies que personne ne peut voir : le casque n'est pas dessiné tant qu'il est au-dessus de sa scène, ni la carte orbitale tant qu'elle est cachée sous le casque ou au repos hors de l'écran.
Un contrôleur qui part du natif
lib/render-quality est un contrôleur unique pour toutes les couches WebGL. Chaque couche déclare les résolutions internes auxquelles elle peut être dessinée et la quantité de détail qu'elle porte ; toutes démarrent à 1. Toutes les 30 images, le contrôleur rapproche la part d'images manquées (un intervalle supérieur à 1,5 fois l'intervalle de rafraîchissement propre à l'écran) et le temps GPU des couches, mesuré par EXT_disjoint_timer_query_webgl2 autour de leurs dessins, d'un budget WebGL de 75 % de cet intervalle. Il ne baisse une couche d'un cran qu'après deux fenêtres consécutives où des images manquent et où le travail GPU dépasse le budget : un à-coup dû au CPU ne coûte donc jamais de résolution. Il remonte après trois fenêtres de marge. Chaque décision est consignée dans un journal (window.__dmRQ), ce qui nous permet de vérifier qu'une machine rapide ne quitte jamais le natif.
// lib/render-quality/index.ts (extrait)
const budget = rf * 0.75; // the WebGL share of the refresh interval
if (missed > 0.1 && gpu > budget) { over++; under = 0; }
else if (missed < 0.02 && gpu < budget * 0.6) { under++; over = 0; }
Une seule couche y est inscrite aujourd'hui : le champ de brouillard de la carte orbitale, un champ lisse de bruit de valeur imbriqué, dessiné dans une cible de 640 pixels de large, avec des crans à 1, 0,7, 0,5 et 0,35. Nous avons évalué les calculs du shader en double précision et reconstruit chaque cran en bilinéaire jusqu'à 640 : l'erreur maximale est de 0,07/255 à 448 pixels, 0,17/255 à 320 et 0,32/255 à 224, sous un pas de 8 bits partout. Parce que cette reconstruction est exacte au pas de 8 bits près, c'est la seule couche autorisée à suivre les seuls temps d'image sur les navigateurs qui n'exposent pas l'extension de minuterie.
Méthode : prédire un téléphone que nous n'avons pas
Nous avons choisi une référence basse : le Samsung Galaxy A14 5G, un téléphone d'entrée de gamme courant, doté d'un GPU Arm Mali-G57 MC2, émulé à sa fenêtre (412×915 pixels CSS, ratio de pixels 2,625). Faute d'avoir ce téléphone, nous avons construit une estimation en trois temps :
- Un chronométrage GPU par couche sur l'iGPU Intel, à cette fenêtre : une requête de minuterie autour de chaque dessin, regroupée par canvas et par programme. Il dit où passe le temps sur ce GPU, pas sur un Mali.
- Les cycles des shaders, donnés par l'Arm Mali Offline Compiler (
malioc) compilant pour Mali-G57 les 41 programmes WebGL que le site lie réellement, extraits de la page en fonctionnement : cycles par fragment sur le chemin le plus long, registres de travail, débordement. - Le « prédicteur A14 » : à chaque moment d'un parcours scripté (héros, arrivée VR, rotation, plongée, tableau de bord, cartes, 60 % de la page, bas de page), une image est rejouée en faisant passer chaque dessin par un programme jumeau de comptage (même vertex shader et mêmes uniformes, un fragment shader qui ajoute 1/255) dans un tampon de travail relu ensuite. On obtient le nombre exact de fragments de chaque dessin. Le temps GPU prédit est la somme des fragments × cycles
malioc, divisée par 2 cœurs × environ 950 MHz ; cette fréquence est une hypothèse.
Le modèle a des angles morts nets. Il ne compte que l'ombrage des fragments : le compositeur du navigateur (chaque canvas WebGL est un calque plein écran), la bande passante mémoire et les chargements et écritures de tuiles, les vertex shaders, le mélange et le coût du pilote par dessin ne sont pas modélisés ; les maillages testés en profondeur sont comptés sans l'élimination par profondeur, et le chemin le plus long du compilateur est un majorant par fragment. Côté CPU, les mesures viennent du bridage CPU ×5 de Chrome sur notre machine de banc, dont le bruit atteignait environ ±30 % d'une fenêtre à l'autre. Le prédicteur nous sert à classer les chantiers, pas à annoncer une fréquence d'images pour un téléphone.
Prouver que les pixels n'ont pas changé
Chaque changement a été vérifié par un A/B entre deux URL qui ne diffèrent que par lui, capturées dans un harnais déterministe : horloge factice avançant par pas de 16 ms, Math.random à graine fixe, mouvements CSS figés ou mouvement réduit activé, mêmes positions de scroll, à la fenêtre de l'A14 et en 1536×864 à l'échelle 1,25. Chaque paire est classée par égalité exacte, écart maximal, SSIM et métrique FLIP de NVIDIA, et deux issues seulement sont acceptées : identique, ou aucun canal décalé de plus de 1/255. Le harnais est d'abord lancé A contre A pour mesurer son propre bruit. Tous les changements livrés sont sortis identiques, ou à 1/255 près sur une poignée de pixels (4 ou 5 à une position de scroll sur ordinateur), soit le bruit A/A à cet endroit. Le harnais a aussi prouvé son utilité : la première version du changement sur le verre faisait disparaître le verre d'une carte de carrousel rognée horizontalement ; l'A/B l'a vu, et c'était corrigé avant la livraison.
Deuxième passe : ce qui a changé, ce que cela a rapporté, ce qui n'a pas payé
Les changements, tous identiques au pixel
- Variantes du shader de la Lune (
c897f7e) : des programmes compilés sans le code de lentille, du mode augmenté et d'atténuation quand l'image n'en a pas besoin, et la passe de netteté (CAS) séparée de la passe de lentille de verre, pour que chaque pixel ne soit écrit qu'une fois. Sur Mali-G57, selonmalioc: le composite de netteté passe de 42 à 4,7 cycles par pixel (2,0 sans le mode augmenté), l'atmosphère de 10,1 à 7,75 sans le code de lentille (1,75 quand aucun plafond de texte n'est dessiné), la brume de 7,0 à 4,2. L'ancien composite occupait 64 registres et débordait, à demi-occupation. - Textures : les textures grises stockées sur un seul canal (
R8), environ 47 Mo de mémoire GPU en moins d'après la taille des textures ; et plus de stockage 8k réservé sur les téléphones de 4 Go ou moins, environ 225 Mo, pour des cartes qui n'y sont jamais affichées à cette taille. - Dessins invisibles évités (
dad7167,e7f2a05) : le casque n'est pas dessiné au-dessus de sa scène, ni une fois son canvas entièrement fondu en fin de plongée (il reste positionné, et sa boucle se met en pause tant que le scroll ne bouge pas) ; la carte orbitale n'est pas dessinée quand elle est cachée sous le casque ou au repos hors de l'écran. - Le champ de brouillard confié au contrôleur (
c897f7e) : erreur sous 0,32/255 même à 0,35×, comme plus haut. - Matériaux jumeaux (
e7f2a05) : sur téléphone, l'atmosphère et la brume sont dessinées à la fois dans la copie givrée du verre (une cible de rendu, sans tone mapping) et à l'écran. Avec un seul matériau, three.js recalculait le programme à chaque bascule, à chaque image. Un matériau jumeau identique dessine désormais la copie ; le temps CPU propre au module de la Lune est passé de 306 à 49 ms par seconde à CPU ×5. - Le verre ne mesure que ce qu'il peut atteindre (
9ea01d4) : la bibliothèque de verre relisait à chaque image la position et la visibilité des 48 lentilles. UnIntersectionObservermarque désormais celles qui sont à plus d'un écran, et un saut de scroll de plus d'un demi-écran les mesure toutes. À la fenêtre de l'A14, héros au repos, CPU ×5, deux passages chacun : le coût du verre sur le thread principal passe d'environ 115–130 à environ 32 ms par seconde.
Temps GPU prédit sur le téléphone de référence
| Moment (prédicteur A14) | Avant (ms/image) | Après (ms/image) | Changement principal |
|---|---|---|---|
| Héros | 20,5 | 8,5 | netteté séparée, variantes du shader de la Lune |
| Arrivée VR | 21,7 | 8,3 | idem, et plus de dessins cachés de la carte |
| Rotation VR | 21,5 | 8,1 | idem |
| Plongée VR | 32,6 | 10,7 | plus le brouillard à demi-résolution |
| Tableau de bord | 27,4 | 10,9 | idem |
| Cartes | 22,0 | 6,0 | idem |
| Page à 60 % | 28,4 | 14,8 | l’ombrage des lentilles de verre reste |
| Bas de page | 19,9 | 6,5 | passes de la Lune seules |
Ce sont des prédictions, pas des mesures sur un téléphone : l'ombrage des fragments sur un Mali-G57 MC2 à 950 MHz supposés, rapporté à un budget de 16,7 ms à 60 Hz. « Avant » désigne le site avant cette passe, sur le même build ; « après » inclut le brouillard à 0,5, ce que choisirait le contrôleur sur un appareil hors budget. Dans ce modèle, chaque moment tient désormais le budget, la page à 60 % avec le moins de marge : le programme des lentilles de verre (43 cycles arithmétiques et 28,75 de texture par fragment) y coûte encore environ 8 ms. Comme le compositeur et la bande passante sont laissés de côté, un vrai téléphone sera plus lent que ces chiffres. Nous les lisons comme « le travail des fragments n'est plus le mur évident », et rien de plus.
La seule mesure sur du vrai matériel est celle de Chrome sur l'iGPU Intel du poste de banc (1536×864 à 1,25, sans bridage), en pleine qualité : aucune baisse de résolution, grain et brume actifs. La plongée VR tournait à 47 images par seconde une fois l'ancienne baisse de qualité retirée et avant ces changements, et à 60 après : deux passages, aucune image au-delà de 25 ms, la scène et la page entière à 60 elles aussi. Il s'agit d'un GPU intégré récent, pas d'un téléphone.
Ce qui n'a pas payé
- Les techniques de suréchantillonnage (FSR 1, suréchantillonnage temporel, rendu en damier) : jamais identiques au bit près, elles enfreignent la règle à la source ; sur cette scène, la passe d'agrandissement coûte à peu près ce que fait gagner la résolution interne réduite ; la Lune a déjà une passe de netteté CAS ; et
FSR1NodeetTRAANodede three.js exigent son moteur WebGPU et TSL, pas le moteur WebGL que nous utilisons. - La précision mediump : un petit gain sur certaines passes, et une passe de netteté plus lente (2,25 cycles au lieu de 2,0 dans sa variante allégée).
- Fusionner les contextes WebGL : le fond, le casque, la carte orbitale et le verre ont chacun le leur ; les fusionner revient à réécrire des moteurs indépendants, sans raccourci sûr au pixel près.
- La coque vernie du casque : 17,25 cycles par fragment, 64 registres avec débordement à demi-occupation. Passer ses uniformes en constantes a fait gagner 5 %. Le coût, c'est le BRDF physique, deux lectures d'environnement et trois lumières : le rendu lui-même. Nous n'avons trouvé aucune forme moins coûteuse qui produise les mêmes pixels.
Encore ouvert
À la fenêtre de l'A14, c'est désormais le CPU qui limite en premier. À CPU ×5, le thread principal passe 40 à 90 ms par image à soumettre les dessins via three.js et encoder les appels WebGL, à recalculer les styles et à exécuter les rappels d'IntersectionObserver. Un CPU ×5 sur ordinateur n'est pas le CPU d'un téléphone, et notre machine était trop bruitée pour mesurer de façon fiable d'autres gains CPU. Rien de cette passe n'a été mesuré sur un vrai Galaxy A14. Valider le prédicteur demanderait un A14 5G, avec son Mali-G57 ; le modèle 4G a un Mali-G52, un GPU plus ancien et plus lent que ce modèle avantagerait.
Limites et ce que nous n'avons pas mesuré
- Aucun appareil bas de gamme physique : ni portable Intel HD/UHD 620 ou Iris Xe, ni téléphone Android d'entrée de gamme, ni mesure sur iPhone faite par nous. Tous les chiffres bas de gamme sont de l'émulation sur un seul portable récent.
- L'émulation bas de gamme sature vers 10 images par seconde sur une page vide : elle ne départage pas les builds en régime établi ; les passages à CPU ×6 varient d'un facteur quatre d'une répétition à l'autre ; le gel de 156 s en production et le verdict GPU faible à 34 s sont des passages uniques.
- Aucune donnée terrain (Chrome UX Report ou mesure d'utilisateurs réels) n'est utilisée ici ; les passages Lighthouse sont des mesures de laboratoire sans GPU, deux par build.
- Les modes économie de batterie, le bridage thermique sur de longues sessions et Firefox n'ont pas été mesurés sur le build final. Les chiffres à 164 Hz sont antérieurs à la release du 25 octobre.
- Les chiffres « téléphone » de la deuxième passe sont des prédictions issues d'un modèle de l'ombrage des fragments seul (compositeur, bande passante, vertex et mélange laissés de côté), à une fréquence GPU supposée ; ses chiffres CPU viennent d'un bridage CPU ×5 sur une machine de banc bruitée (environ ±30 %). Sa seule mesure sur du vrai matériel est la plongée à 60 images par seconde sur l'iGPU Intel.
- Les chiffres de mémoire GPU sont des estimations tirées de la taille des textures (notre rapport du 23 octobre estimait environ 396 Mo de mémoire texture au repos sur le portable de banc) ; nous n'avons pas lu de compteurs du pilote.
Ce qui trancherait les questions ouvertes : le même scroll scripté sur un vrai portable Intel UHD 620 et un vrai téléphone Android d'entrée de gamme, cinq passages par build en alternance avec le build de production précédent ; une trace des vingt premières secondes sous émulation pour comprendre pourquoi le verdict GPU faible prend 34 s ; un LCP terrain issu d'utilisateurs réels ; et le parcours scripté de la deuxième passe sur un vrai Galaxy A14 5G, pour confronter le prédicteur à un téléphone.
Ressources complémentaires
La scène décrite ici tourne sur la page d'accueil de dark-moon.org, et la carte orbitale three.js du produit est présentée dans l'article sur le graphe orbital d'infrastructure (en anglais). Pour nos travaux sur les graphes d'attaque immersifs, voir notre état de l'art sur la visualisation de graphes d'attaque en WebXR.
- ASCIT31/Darkmoon-Benchmarks : notre dépôt public de benchmarks de tests d'intrusion par LLM (agents autonomes et modèles face à des laboratoires vulnérables). Il ne mesure ni le WebGL, ni le rendu, ni la performance web, et rien n'y valide les chiffres de cet article.
- ASCIT31/Dark-Moon : l'édition open source de Darkmoon (GPL-3.0), l'interface en ligne de commande et ses agents.
Références
- NASA Scientific Visualization Studio, CGI Moon Kit (mosaïque couleur LRO LROC, altimétrie LOLA), ID 4720. Visualisation Ernie Wright, scientifique Noah Petro. svs.gsfc.nasa.gov/4720
- MDN Web Docs, HTMLCanvasElement.getContext() : attributs de contexte WebGL (failIfMajorPerformanceCaveat, powerPreference, preserveDrawingBuffer). developer.mozilla.org/en-US/docs/Web/API/HTMLCanvasElement/getContext
- MDN Web Docs, extension WEBGL_debug_renderer_info. developer.mozilla.org/en-US/docs/Web/API/WEBGL_debug_renderer_info
- MDN Web Docs, Window.devicePixelRatio. developer.mozilla.org/en-US/docs/Web/API/Window/devicePixelRatio
- MDN Web Docs, Navigator.deviceMemory. developer.mozilla.org/en-US/docs/Web/API/Navigator/deviceMemory
- MDN Web Docs, WebGL2RenderingContext.fenceSync(). developer.mozilla.org/en-US/docs/Web/API/WebGL2RenderingContext/fenceSync
- Khronos Group, registre des extensions WebGL : KHR_parallel_shader_compile. registry.khronos.org/webgl/extensions/KHR_parallel_shader_compile/
- AMD GPUOpen, FidelityFX Contrast Adaptive Sharpening (CAS). gpuopen.com/fidelityfx-cas/
- Khronos Group, registre des extensions WebGL : EXT_disjoint_timer_query_webgl2. registry.khronos.org/webgl/extensions/EXT_disjoint_timer_query_webgl2/
- Arm Developer, Mali Offline Compiler (comptes de cycles statiques par shader pour les GPU Mali). learn.arm.com/learning-paths/smartphones-and-mobile/ams/malioc/
- NVIDIA Research, FLIP : un évaluateur de différences entre images alternées (métrique de différence d’image). github.com/NVlabs/flip
- MDN Web Docs, caractéristique média prefers-reduced-motion. developer.mozilla.org/en-US/docs/Web/CSS/@media/prefers-reduced-motion
- web.dev, Largest Contentful Paint (LCP) : définition et seuils. web.dev/articles/lcp
- 21 Hours on the Moon, le site dont nous avons suivi la construction de la Lune (structure seulement ; aucun fichier réutilisé). 21hrs.space/
La preuve plutôt que le discours : le benchmark de remédiation Pro (correctifs retestés contre l'exploit) · Darkmoon face aux autres outils de pentest IA.
← Tous les articles